
Come l'apprendimento automatico potrebbe cambiare il comportamento dei nemici nei giochi futuri
Annunci
Apprendimento automatico sta trasformando il modo in cui i personaggi non giocanti osservano, si adattano e reagiscono alle moderne strategie di gioco in ambienti digitali complessi.
I giocatori hanno trascorso decenni a sfruttare alberi comportamentali statici, routine di ricerca del percorso prevedibili e un'IA di guardia telepatica che si resetta nel momento in cui scade un timer.
I moderni motori grafici si stanno finalmente liberando dai rigidi vincoli degli script per costruire ecosistemi reattivi che apprendono direttamente dalle decisioni del giocatore.
La progettazione tradizionale dei nemici si basa in gran parte su macchine a stati finiti predefinite, in cui gli sviluppatori programmano manualmente ogni ramo decisionale, limite e condizione.
Quando i giocatori scoprono una falla in quegli script statici, l'illusione della sfida si infrange all'istante, lasciando il gioco banale.
Annunci
Gli algoritmi dinamici consentono agli sviluppatori di addestrare reti neurali su milioni di interazioni tra giocatori, creando avversari che adattano le proprie tattiche in tempo reale.
Cosa scoprirai in questo articolo
- Cos'è l'apprendimento automatico nella progettazione di videogiochi?
- In che modo le reti neurali sostituiscono gli script statici?
- Perché le sceneggiature tradizionali dei nemici non funzionano per i giocatori moderni?
- In che modo l'apprendimento per rinforzo addestra gli avversari virtuali?
- In che modo il comportamento dinamico rimodella i sistemi di combattimento dinamici?
- Perché le tattiche di aggiramento adattive stanno sostituendo le pattuglie fisse?
- Come possono le squadre NPC coordinare le tattiche senza barare?
- Che ruolo gioca la ricerca predittiva del percorso nei giochi stealth?
- Cosa riserva il futuro all'intelligence nemica di prossima generazione?
- Perché la memoria procedurale è essenziale per i rivali più agguerriti?
- In che modo il cloud computing elaborerà i modelli comportamentali in tempo reale?
- Quali sono i limiti architetturali dei sistemi di intelligenza artificiale imprevedibili?
- Analisi comparativa: script statici vs. intelligenza artificiale basata sull'apprendimento automatico
- L'alba degli avversari digitali viventi
- Domande frequenti
Cos'è l'apprendimento automatico nella progettazione di videogiochi?
In che modo le reti neurali sostituiscono gli script statici?
Avanzato apprendimento automatico I framework sostituiscono i cicli condizionali "se-allora" con reti di policy flessibili che valutano continuamente i vettori di stato del gioco in tempo reale.
Anziché seguire rigide linee di codice scritte dai progettisti, questi sistemi valutano simultaneamente distanza, linea di vista, riserve di salute e scelta delle armi per selezionare le contro-strategie ottimali.
Questo cambiamento fondamentale trasforma i bersagli digitali statici in avversari flessibili che analizzano gli schemi di combattimento e adattano dinamicamente il loro posizionamento durante gli scontri.
L'implementazione richiede l'addestramento di modelli su vasti set di dati relativi al movimento dei giocatori, alla gestione delle risorse e al posizionamento tattico, al fine di stabilire parametri comportamentali di base.
Gli sviluppatori inseriscono scenari di combattimento simulati nelle pipeline di apprendimento profondo, consentendo al sistema di affinare le proprie risposte attraverso milioni di battaglie iterative prima del rilascio.
L'agente runtime finale utilizza modelli di inferenza leggeri per elaborare istantaneamente gli input del giocatore, mantenendo una fluidità ottimale dei frame rate e prendendo decisioni intelligenti e contestualizzate.
Perché le sceneggiature tradizionali dei nemici non funzionano per i giocatori moderni?
Gli script nemici convenzionali si basano su macchine a stati finiti deterministiche che crollano sotto il peso di strategie creative e imprevedibili da parte dei giocatori.
I giocatori esperti memorizzano rapidamente i percorsi di pattugliamento, i coni di visuale e gli intervalli di attacco, riducendo gli scontri ad alto rischio a ripetitivi enigmi spaziali.
Una volta che un giocatore scopre un punto cieco non previsto o un glitch nella geometria del percorso, la sfida artificiale scompare completamente.
Anche i nemici predefiniti soffrono di una divisione artificiale tra la capacità di tracciamento onnisciente e la cecità totale, passando spesso dall'uno all'altro stato istantaneamente.
O possiedono una conoscenza soprannaturale delle coordinate esatte del giocatore grazie alla capacità di leggere la geometria dei muri, oppure restano ignari mentre gli alleati atterrano nelle vicinanze.
Questo modello operativo binario compromette l'immersione del giocatore, evidenziando i limiti meccanici dell'architettura di gioco tradizionale.
++ Il futuro dei giochi a mondo condiviso oltre la formula MMO
In che modo l'apprendimento per rinforzo addestra gli avversari virtuali?
I modelli di apprendimento per rinforzo utilizzano funzioni di ricompensa per incentivare gli avversari virtuali a raggiungere obiettivi strategici come il controllo spaziale, l'esecuzione di attacchi sui fianchi e la sopravvivenza.
Gli agenti digitali ricevono un feedback matematico positivo quando riescono a bloccare le vie di fuga dei giocatori o a preservare la salute della squadra durante gli scontri a fuoco.
Attraverso milioni di iterazioni di auto-gioco all'interno di ambienti simulati, gli agenti scoprono in modo naturale sofisticate manovre tattiche senza istruzioni esplicite da parte degli sviluppatori.
Sony AI ha dimostrato questo potenziale trasformativo sviluppando Gran Turismo Sophy, un agente addestrato tramite apprendimento per rinforzo profondo che ha padroneggiato dinamiche complesse dei veicoli, traiettorie di gara e posizionamenti difensivi per sconfiggere i migliori campioni umani di eSport.
Anziché ricevere percorsi di guida preimpostati, Sophy ha imparato i punti di frenata ottimali e le tecniche di sorpasso tattico attraverso continui tentativi ed errori.
Applicare architetture di addestramento simili ai giochi d'azione permette ai nemici di apprendere complesse meccaniche di combattimento con una precisione simile a quella umana.
In che modo il comportamento dinamico rimodella i sistemi di combattimento dinamici?
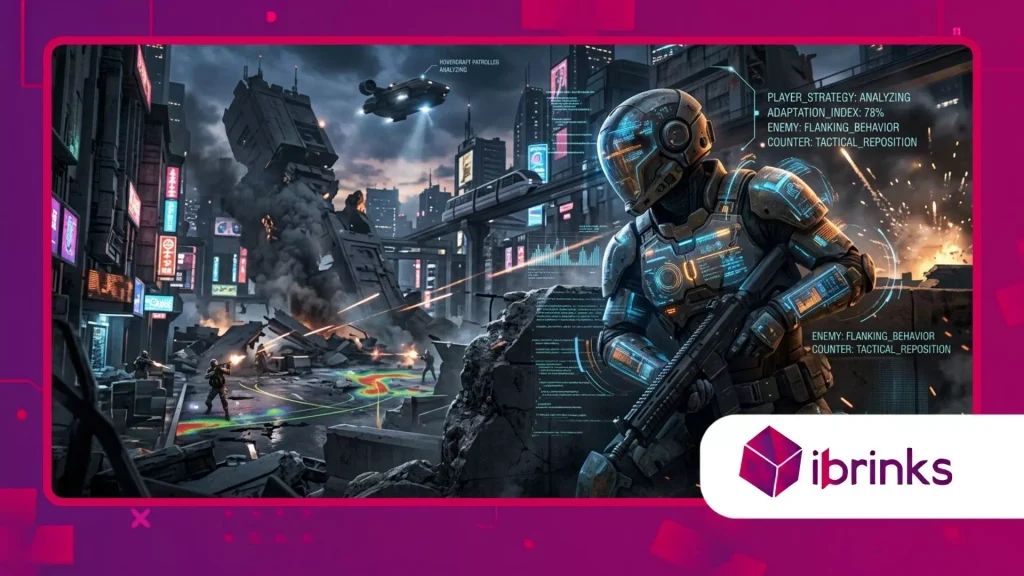
Perché le tattiche di aggiramento adattive stanno sostituendo le pattuglie fisse?
I moderni scontri a fuoco richiedono avversari adattabili che regolino i propri movimenti spaziali in base alla posizione del giocatore, alla disponibilità di ripari e alla soppressione del fuoco nemico.
Anziché seguire punti di copertura predefiniti, i nemici, grazie a modelli dinamici, valutano la geometria del terreno in tempo reale per individuare angoli di tiro vantaggiosi.
Questa evoluzione strutturale costringe i giocatori ad abbandonare le strategie di campeggio statico, poiché gli avversari digitali si muovono attivamente intorno alle coperture per sfondare le posizioni difensive.
Gli agenti adattivi analizzano la gittata delle armi, i cicli di ricarica e l'esposizione della linea di vista per eseguire tattiche di pressione su più fronti senza l'intervento del progettista.
Quando un giocatore concentra il fuoco in una direzione, le unità sui fianchi individuano il punto cieco visivo e avanzano lungo i canali soppressi.
Questo movimento fluido crea scenari di combattimento organici in cui le linee di battaglia si spostano dinamicamente in base alle prestazioni del giocatore, anziché a eventi predefiniti.
Leggi anche: L'ascesa di piani di sviluppo definiti dalla comunità che sostituiscono i piani di sviluppo fissi.
Come possono le squadre NPC coordinare le tattiche senza barare?
Nei giochi più datati, l'intelligenza di gruppo veniva spesso simulata fornendo ai membri della squadra dati di telemetria condivisi, che permettevano loro di tracciare i giocatori anche attraverso superfici solide.
Moderno apprendimento automatico I modelli consentono un autentico coordinamento di squadra attraverso protocolli di comunicazione localizzati, simulando unità tattiche reali che condividono dati di visibilità organici alla loro prospettiva.
I nemici reagiscono esclusivamente alle informazioni verificate dai propri sensori visivi o acustici, garantendo il fair play e dimostrando al contempo una sofisticata strategia di squadra.
I modelli di squadra coordinati distribuiscono i ruoli tattici in modo dinamico, assegnando fuoco di soppressione, copertura della ritirata e manovre di aggiramento in base alla salute e all'armamento dell'unità.
Se un'unità pesante avanza con uno scudo, i fucilieri di supporto si mettono automaticamente al riparo dietro il carro armato in avanzata per esercitare pressione sulla posizione del giocatore.
Questo coordinamento emergente appare autentico perché ogni unità agisce sulla base di dati reali raccolti sul campo, anziché ricorrere a soluzioni di basso livello generate automaticamente.
Per saperne di più: Come i giochi moderni bilanciano libertà e guida senza essere presi per mano
Che ruolo gioca la ricerca predittiva del percorso nei giochi stealth?
Il gameplay stealth cambia radicalmente quando gli algoritmi di ricerca sostituiscono i percorsi di pattugliamento lineari con mappe di calore probabilistiche derivate dalle abitudini del giocatore.
Anziché seguire percorsi prestabiliti, i modelli di ricerca predittiva valutano le violazioni della linea di vista, le porte aperte e le tracce sonore per stimare dove si nascondono i giocatori che adottano uno stile di gioco furtivo.
I nemici concentrano i loro sforzi investigativi sui nascondigli più probabili, trasformando le fasi di ricerca di routine in tese manovre di elusione tattica.
Gli algoritmi predittivi di ricerca del percorso calcolano i potenziali vettori di movimento in base a quanto tempo un giocatore è rimasto fuori dal contatto visivo diretto.
Se scatta un allarme sul perimetro, le guardie calcolano la distanza massima che un giocatore potrebbe percorrere in quel lasso di tempo e definiscono di conseguenza i perimetri di perquisizione.
Vi siete mai chiesti quanto possano diventare terrificanti gli scontri furtivi quando le guardie anticipano attivamente la vostra via di fuga invece di seguire le tracce?
Cosa riserva il futuro all'intelligence nemica di prossima generazione?
Perché la memoria procedurale è essenziale per i rivali più agguerriti?
I sistemi di rivalità persistenti utilizzano architetture di memoria a lungo termine per conservare i dati relativi agli stili di gioco dei giocatori, alle armi preferite e alle tendenze di combattimento nel corso di campagne prolungate.
Quando un nemico sopravvive a uno scontro, il suo modello sottostante aggiorna i pesi decisionali per contrastare le tattiche specifiche che lo hanno sconfitto in precedenza.
Se un giocatore fa molto affidamento sui fucili di precisione a lunga gittata, gli avversari che ritornano si presentano con granate fumogene, armature pesanti e tattiche di attacco ravvicinato.
La memoria procedurale trasforma gli scontri ricorrenti con i nemici, che non si limitano a semplici controlli delle statistiche, in rivalità personali in continua evoluzione che riflettono la storia del giocatore.
Gli avversari ricordano le cicatrici fisiche, le sconfitte tattiche e le fughe rocambolesche, e questo influenza le loro risposte verbali e il loro comportamento in combattimento durante gli scontri successivi.
Questa continuità storica intensifica il coinvolgimento dei giocatori a lungo termine, poiché ogni vittoria tattica rimodella il quadro generale delle minacce.
In che modo il cloud computing elaborerà i modelli comportamentali in tempo reale?
L'esecuzione di complessi modelli di inferenza di reti neurali in concomitanza con il rendering grafico di fascia alta presenta seri colli di bottiglia prestazionali per l'hardware delle console locali.
L'architettura basata sul cloud risolve questo limite di calcolo eseguendo modelli comportamentali intensivi su server remoti e trasmettendo in streaming le decisioni tattiche ottimizzate al client di gioco.
Questo alleggerisce il carico di lavoro dei processori locali, consentendo agli sviluppatori di implementare fazioni nemiche massicce e altamente intelligenti senza compromettere il frame rate.
Le reti di cloud computing distribuite consentono a migliaia di istanze di gioco attive di inviare continuamente dati anonimizzati sulle decisioni dei giocatori a un modello centralizzato.
Mentre milioni di giocatori in tutto il mondo testano nuove vulnerabilità, la rete centralizzata aggiorna in tempo reale le contromisure nemiche per l'intera base di giocatori.
Questo ciclo continuo di dati garantisce che l'intelligence nemica si evolva di pari passo con le strategie della comunità globale, prevenendo la stagnazione del metagioco.
Quali sono i limiti architetturali dei sistemi di intelligenza artificiale imprevedibili?
L'integrazione di modelli comportamentali autonomi in giochi narrativi strutturati presenta serie sfide di game design per quanto riguarda il controllo, il ritmo e la soddisfazione del giocatore.
Se un modello nemico impara pure In modo efficiente, scopre cicli di combattimento imbattibili, routine di puntamento perfette al pixel e tattiche di soppressione istantanee che lasciano i giocatori frustrati.
I progettisti di videogiochi devono stabilire rigidi limiti comportamentali per limitare l'efficienza dell'IA, garantendo che gli avversari rimangano una sfida senza però diventare ingiusti o frustranti.
Gli sviluppatori utilizzano curve di utilità, ritardi di reazione intenzionali e probabilità di fallimento per rendere i modelli neurali avanzati divertenti da utilizzare.
Il bilanciamento dei motori decisionali dinamici richiede test rigorosi per prevenire bug comportamentali imprevisti o routine di combattimento che compromettano l'equilibrio del gioco.
Trovare il giusto equilibrio tra un'autentica intelligenza digitale e un feedback appagante tipico dei giochi arcade rimane la sfida principale per gli architetti di videogiochi moderni.
Analisi comparativa: script statici vs. intelligenza artificiale basata sull'apprendimento automatico
La transizione strutturale da pipeline di script deterministiche a modelli comportamentali adattivi trasforma il modo in cui gli avversari digitali reagiscono alle decisioni dei giocatori.
La tabella seguente illustra le differenze operative tra le macchine a stati finiti tradizionali e le moderne reti di policy addestrate, in relazione alle principali dimensioni del gameplay.
| Caratteristica di gioco | Macchine a stati finiti tradizionali | Reti comportamentali di apprendimento automatico |
| Ricerca del percorso e navigazione | Nodi waypoint fissi, linee di griglia rigide | Valutazione dinamica della geometria spaziale, attraversamento in tempo reale |
| Adattamento al combattimento | Condizioni di attivazione predefinite | Aggiornamenti continui delle policy basati sulle tattiche dei giocatori in tempo reale |
| Coordinamento della squadra | Dati di telemetria condivisi (lettura a parete) | Trasmissione di dati tramite sensori localizzati, condivisione autentica delle informazioni. |
| Logica di ricerca furtiva | Percorsi di pattugliamento lineari, coni di visione fissi | Mappe di calore probabilistiche, ricerca spaziale predittiva |
| Memoria a lungo termine | Ripristina lo stato alla morte/al respawn del giocatore. | Persistenza del peso corporeo durante diverse sessioni di gioco. |
| Flusso di lavoro di sviluppo | Codifica manuale di ogni ramo decisionale | Addestramento automatizzato basato su scenari tramite cicli di rinforzo |
L'alba degli avversari digitali viventi
L'integrazione di apprendimento automatico Nel design dei videogiochi moderni si assiste a un cambiamento fondamentale, che si allontana dai bersagli digitali prevedibili per orientarsi verso avversari vivi e pulsanti.
Con la maturazione dei modelli di addestramento neurale e il perfezionamento delle pipeline di inferenza cloud, i mondi di gioco presenteranno ecosistemi in grado di osservare, adattarsi ed evolversi in base alle strategie dei giocatori.
Questa tecnologia cambia radicalmente il modo in cui i giocatori affrontano le sfide tattiche, trasformando le campagne statiche in battaglie dinamiche di intelligenza e adattamento.
Gli sviluppatori di videogiochi hanno il potere di creare mondi virtuali che mettano alla prova i giocatori senza ricorrere a potenziamenti artificiali delle statistiche o a banali trucchi programmatici per superare i muri.
I giocatori non potranno più superare gli scontri di alto livello memorizzando i percorsi di pattugliamento o sfruttando nodi geometrici difettosi; la vittoria richiederà una reale flessibilità tattica e capacità di risoluzione creativa dei problemi.
Man mano che questi sistemi adattivi si evolvono, condividete nei commenti le vostre esperienze su come gli incontri con l'IA intelligente hanno modificato i vostri momenti di gioco preferiti.
Domande frequenti
I modelli comportamentali avanzati dei nemici renderanno i videogiochi del futuro troppo difficili per i giocatori occasionali?
No, gli sviluppatori implementano sistemi di scalatura della difficoltà personalizzabili che regolano la latenza di risposta, la precisione e l'aggressività tattica dei modelli addestrati.
Anziché basarsi esclusivamente su moltiplicatori di danno grezzi, i cursori di difficoltà modificano la velocità con cui le reti neurali analizzano le azioni del giocatore ed eseguono le contromisure, garantendo esperienze accessibili a tutti i livelli di abilità.
L'implementazione dell'inferenza neurale in tempo reale compromette il frame rate del sistema sulle console moderne?
Le moderne piattaforme hardware utilizzano blocchi di elaborazione neurale dedicati per eseguire in modo efficiente modelli di inferenza leggeri insieme alle pipeline di rendering.
Grazie all'utilizzo di reti neurali ottimizzate, i motori grafici elaborano decisioni comportamentali complesse in intervalli di tempo ristrettissimi, dell'ordine dei microsecondi, mantenendo una fluidità impeccabile anche durante le scene di combattimento più intense.
Come fanno gli sviluppatori di videogiochi a impedire che i nemici adattivi scoprano strategie di combattimento imbattibili?
I progettisti introducono rigide condizioni al contorno, limiti di utilità e ritardi di reazione intenzionali all'interno della funzione di ricompensa per restringere le capacità degli agenti.
Questi vincoli intenzionali impediscono ai modelli di sfruttare vantaggi meccanici come la mira perfetta, la velocità di rotazione istantanea o i cicli di soppressione infiniti, mantenendo gli scontri a fuoco coinvolgenti ed equi.
I sistemi di comportamento adattivo dei nemici possono funzionare nei giochi offline senza una connessione internet attiva?
Sì, gli sviluppatori addestrano complessi modelli di reti neurali durante la produzione del gioco su server cloud ad alte prestazioni, quindi comprimono la policy addestrata finale in un file runtime leggero.
L'hardware locale legge offline questo file modello pre-addestrato, consentendo un comportamento adattivo sofisticato senza richiedere connessioni attive al server o streaming su Internet.
In che modo l'apprendimento per rinforzo si differenzia dagli script di programmazione di giochi tradizionali?
La programmazione tradizionale dei videogiochi si basa sulla scrittura manuale da parte di sviluppatori umani di ogni istruzione condizionale, regola e albero decisionale per un agente nemico.
L'apprendimento per rinforzo fornisce a un agente obiettivi, vincoli ambientali e un sistema di ricompense, consentendo al sistema di scoprire manovre tattiche ottimali attraverso milioni di iterazioni di auto-gioco.
