
Comment l'apprentissage automatique pourrait modifier le comportement des ennemis dans les jeux futurs
Annonces
apprentissage automatique transforme la manière dont les personnages non-joueurs observent, s'adaptent et réagissent aux stratégies de jeu modernes dans des environnements numériques complexes.
Les joueurs ont passé des décennies à exploiter des arbres de comportement statiques, des routines de recherche de chemin prévisibles et une IA de garde télépathique qui se réinitialise dès qu'un minuteur expire.
Les moteurs de jeu modernes s'affranchissent enfin des contraintes rigides des scripts pour construire des écosystèmes réactifs qui apprennent directement des décisions des joueurs.
La conception traditionnelle des ennemis repose largement sur des automates à états finis codés en dur, où les développeurs programment manuellement chaque branche de décision, limite et condition.
Lorsque les joueurs découvrent une faille dans ces scripts statiques, l'illusion du défi se brise instantanément, rendant le jeu trivial.
Annonces
Les algorithmes dynamiques permettent aux développeurs d'entraîner des réseaux neuronaux sur des millions d'interactions entre joueurs, créant ainsi des adversaires qui adaptent leurs tactiques en temps réel.
Ce que vous découvrirez dans cet article
- Qu’est-ce que l’apprentissage automatique dans la conception de jeux ?
- Comment les réseaux neuronaux remplacent-ils les scripts statiques ?
- Pourquoi les scripts ennemis traditionnels échouent-ils face aux joueurs modernes ?
- Comment l'apprentissage par renforcement entraîne-t-il les adversaires virtuels ?
- Comment le comportement dynamique remodèle-t-il les systèmes de combat dynamiques ?
- Pourquoi les tactiques de contournement adaptatives remplacent-elles les patrouilles fixes ?
- Comment les escouades de PNJ peuvent-elles coordonner leurs tactiques sans tricher ?
- Quel rôle joue la recherche de chemin prédictive dans les jeux d'infiltration ?
- Quel avenir pour le renseignement ennemi de nouvelle génération ?
- Pourquoi la mémoire procédurale est-elle essentielle pour les rivaux persistants ?
- Comment le cloud computing traitera-t-il les modèles comportementaux en temps réel ?
- Quelles sont les limites architecturales des systèmes d'IA imprévisibles ?
- Analyse comparative : scripts statiques vs. IA d’apprentissage automatique
- L'aube des adversaires numériques vivants
- Questions fréquemment posées
Qu’est-ce que l’apprentissage automatique dans la conception de jeux ?
Comment les réseaux neuronaux remplacent-ils les scripts statiques ?
Avancé apprentissage automatique Les frameworks remplacent les boucles conditionnelles « si-alors » par des réseaux de politiques flexibles qui évaluent en continu les vecteurs d'état du jeu en direct.
Au lieu de suivre des lignes de code rigides écrites par les concepteurs, ces systèmes évaluent simultanément la distance, la ligne de mire, les réserves de santé et les choix d'armes afin de sélectionner les contre-stratégies optimales.
Ce changement fondamental transforme les cibles numériques statiques en adversaires flexibles qui analysent les schémas de combat et ajustent dynamiquement leur positionnement lors des affrontements actifs.
La mise en œuvre nécessite l'entraînement de modèles sur de vastes ensembles de données concernant les mouvements des joueurs, la gestion des ressources et le positionnement tactique afin d'établir des paramètres comportementaux de base.
Les développeurs alimentent des pipelines d'apprentissage profond avec des scénarios de combat simulés, permettant ainsi au système d'affiner ses réponses au fil de millions de batailles itératives avant sa mise en service.
L'agent d'exécution final utilise des modèles d'inférence légers pour traiter instantanément les entrées du joueur, maintenant ainsi une fréquence d'images fluide tout en prenant des décisions intelligentes et contextuelles.
Pourquoi les scripts ennemis traditionnels échouent-ils face aux joueurs modernes ?
Les scripts ennemis classiques reposent sur des automates finis déterministes qui s'effondrent sous le poids des stratégies de joueurs créatives et imprévisibles.
Les joueurs expérimentés mémorisent rapidement les itinéraires de patrouille, les champs de vision et les intervalles d'attaque, réduisant ainsi les combats à enjeux élevés à de simples énigmes spatiales répétitives.
Dès qu'un joueur découvre un angle mort non prévu ou une faille dans la géométrie du système de navigation, le défi artificiel disparaît complètement.
Les ennemis scriptés souffrent également d'une division artificielle entre le suivi omniscient et la cécité totale, passant souvent instantanément d'un état à l'autre.
Soit ils possèdent une connaissance surnaturelle des coordonnées exactes du joueur grâce à la lecture de la géométrie des murs, soit ils restent inconscients tandis que des alliés tombent à proximité.
Ce modèle opérationnel binaire brise l'immersion du joueur, mettant en évidence les limitations mécaniques de l'architecture de jeu traditionnelle.
++ L'avenir des jeux en monde partagé au-delà de la formule MMO
Comment l'apprentissage par renforcement entraîne-t-il les adversaires virtuels ?
Les modèles d'apprentissage par renforcement utilisent des fonctions de récompense pour inciter les adversaires virtuels à atteindre des objectifs stratégiques tels que le contrôle spatial, l'exécution sur les flancs et la survie.
Les agents numériques reçoivent un retour mathématique positif lorsqu'ils parviennent à bloquer les voies d'évacuation des joueurs ou à préserver la santé de leur escouade pendant les fusillades.
Grâce à des millions d'itérations d'auto-jeu dans des environnements simulés, les agents découvrent naturellement des manœuvres tactiques sophistiquées sans instruction explicite du développeur.
Sony AI a démontré ce potentiel transformateur en développant Sony AI's Gran Turismo Sophy, un agent entraîné par apprentissage par renforcement profond qui a maîtrisé la dynamique complexe des véhicules, les trajectoires de course et le positionnement défensif pour vaincre les meilleurs champions humains d'e-sport.
Plutôt que de recevoir des trajectoires de conduite prédéfinies, Sophy a appris les points de freinage optimaux et les dépassements tactiques par une méthode continue d'essais et d'erreurs.
L'application de systèmes d'entraînement similaires aux jeux d'action permet aux ennemis d'apprendre des mécanismes de combat complexes avec une précision quasi humaine.
Comment le comportement dynamique remodèle-t-il les systèmes de combat dynamiques ?
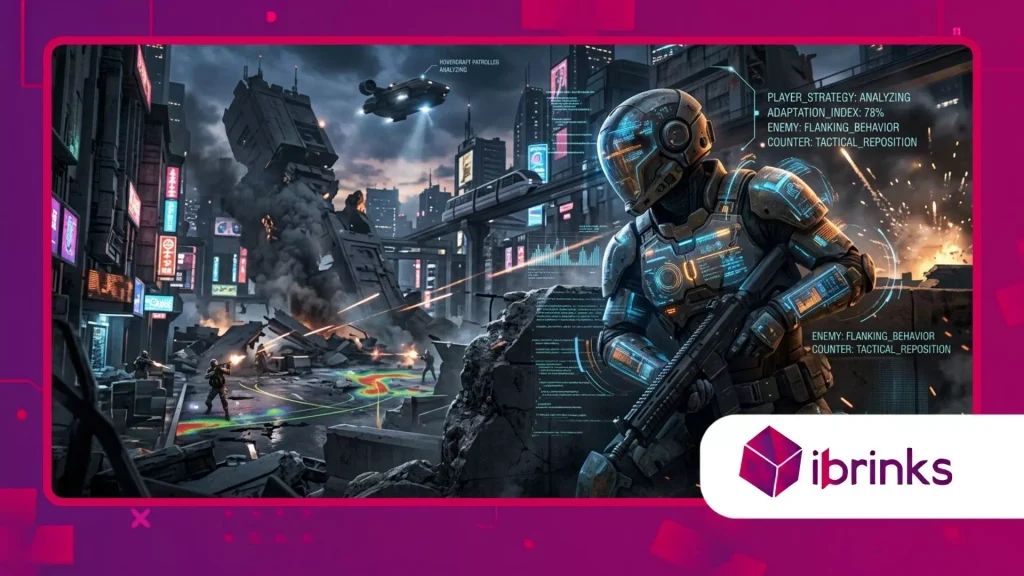
Pourquoi les tactiques de contournement adaptatives remplacent-elles les patrouilles fixes ?
Les combats modernes nécessitent des adversaires adaptatifs qui ajustent leurs déplacements spatiaux en fonction de la position du joueur, de la disponibilité des abris et de la suppression des armes.
Au lieu de se déplacer le long de points de couverture prédéfinis, les ennemis, grâce à des modèles dynamiques, évaluent la géométrie du terrain en temps réel pour localiser des angles de tir avantageux.
Cette évolution structurelle oblige les joueurs à abandonner les stratégies de camping statiques, car leurs adversaires numériques se déplacent activement autour des abris pour percer les positions défensives.
Les agents adaptatifs analysent les portées des armes, les cycles de rechargement et l'exposition du champ de vision pour exécuter des tactiques de pression à plusieurs volets sans intervention du concepteur.
Lorsqu'un joueur concentre ses tirs dans une direction, les unités de flanc repèrent l'angle mort visuel et progressent le long des couloirs neutralisés.
Cette fluidité des mouvements crée des scénarios de combat organiques où les lignes de bataille évoluent dynamiquement en fonction des performances des joueurs plutôt que de déclencheurs prédéfinis.
Lire aussi : L'essor des feuilles de route élaborées par la communauté en remplacement des plans de développement fixes
Comment les escouades de PNJ peuvent-elles coordonner leurs tactiques sans tricher ?
Les jeux vidéo traditionnels simulaient fréquemment l'intelligence collective en fournissant aux membres de l'escouade des données télémétriques partagées, leur permettant de suivre les joueurs à travers des surfaces solides.
Moderne apprentissage automatique Ces modèles permettent une coordination authentique des escouades grâce à des protocoles de communication localisés, imitant les unités tactiques du monde réel qui partagent des données de visibilité propres à leur perspective.
Les ennemis réagissent uniquement aux informations vérifiées par leurs propres capteurs visuels ou acoustiques, ce qui garantit le fair-play tout en faisant preuve d'une stratégie d'équipe sophistiquée.
Les modèles d'escouades coordonnées répartissent dynamiquement les rôles tactiques, attribuant des tirs de suppression, une couverture de retraite et des manœuvres de flanc en fonction de la santé et de l'armement de l'unité.
Si une unité lourde avance avec un bouclier, les fusiliers de soutien se mettent automatiquement à couvert derrière les blindés qui avancent afin de mettre la pression sur la position du joueur.
Cette coordination émergente paraît authentique car chaque unité agit sur la base de données de terrain crédibles plutôt que par des astuces logicielles bon marché.
En savoir plus: Comment les jeux modernes trouvent un équilibre entre liberté et accompagnement sans prise par la main
Quel rôle joue la recherche de chemin prédictive dans les jeux d'infiltration ?
Le gameplay furtif change radicalement lorsque les algorithmes de recherche remplacent les boucles de patrouille linéaires par des cartes thermiques probabilistes dérivées des habitudes des joueurs.
Au lieu de suivre des chemins fixes, les modèles de recherche prédictive évaluent les brèches dans la ligne de mire, les portes ouvertes et les signatures sonores pour estimer où se cachent les joueurs furtifs.
Les ennemis concentrent leurs efforts de recherche sur les cachettes les plus probables, transformant les phases de fouille de routine en évasions tactiques tendues.
Les algorithmes de prédiction de trajectoire calculent les vecteurs de mouvement potentiels en fonction de la durée pendant laquelle un joueur est hors de contact visuel direct.
Si une alarme se déclenche au périmètre, les gardes calculent la distance maximale qu'un joueur pourrait parcourir dans ce laps de temps et établissent des périmètres de recherche en conséquence.
Vous êtes-vous déjà demandé à quel point les rencontres furtives deviennent terrifiantes lorsque les gardes anticipent activement votre itinéraire de fuite au lieu de suivre des indices ?
Quel avenir pour le renseignement ennemi de nouvelle génération ?
Pourquoi la mémoire procédurale est-elle essentielle pour les rivaux persistants ?
Les systèmes de rivalité persistante utilisent des architectures de mémoire à long terme pour conserver les enregistrements des styles de jeu des joueurs, de leurs armes favorites et de leurs tendances de combat tout au long de campagnes prolongées.
Lorsqu'un ennemi survit à un affrontement, son modèle sous-jacent met à jour ses pondérations de décision afin de contrer les tactiques spécifiques qui l'ont vaincu précédemment.
Si un joueur s'appuie fortement sur des fusils de précision à longue portée, ses rivaux réapparaissent équipés de grenades fumigènes, d'armures lourdes et de tactiques d'assaut rapproché.
La mémoire procédurale transforme les rencontres récurrentes avec les ennemis, qui se résument souvent à des vérifications de statistiques répétitives, en rivalités personnelles évolutives reflétant l'histoire du joueur.
Les adversaires se souviennent des cicatrices physiques, des défaites tactiques et des évasions de justesse, ce qui modifie leurs réponses verbales et leur comportement au combat lors des affrontements suivants.
Cette continuité historique renforce l'engagement à long terme des joueurs, car chaque victoire tactique remodèle l'environnement de menace global.
Comment le cloud computing traitera-t-il les modèles comportementaux en temps réel ?
L'exécution de modèles d'inférence de réseaux neuronaux complexes parallèlement au rendu graphique haut de gamme présente de sérieux goulots d'étranglement en termes de performances pour le matériel de la console locale.
L'architecture assistée par le cloud résout cette contrainte de calcul en exécutant des modèles comportementaux intensifs sur des serveurs distants et en renvoyant en continu des décisions tactiques optimisées au client de jeu.
Cela décharge les processeurs locaux des calculs complexes d'algèbre linéaire, permettant ainsi aux développeurs de déployer des factions ennemies massives et très intelligentes sans compromettre la fréquence d'images.
Les réseaux de calcul distribués en nuage permettent à des milliers d'instances de jeu actives de réinjecter en continu des données anonymisées sur les décisions des joueurs dans un modèle centralisé.
Tandis que des millions de joueurs testent de nouvelles failles à travers le monde, le réseau centralisé met à jour en temps réel les contre-stratégies ennemies pour l'ensemble des joueurs.
Cette boucle de données continue garantit que les renseignements ennemis évoluent en parallèle des stratégies de la communauté mondiale, empêchant ainsi la stagnation du méta-jeu.
Quelles sont les limites architecturales des systèmes d'IA imprévisibles ?
L'intégration de modèles comportementaux autonomes dans des jeux narratifs structurés pose de sérieux défis en matière de conception de jeux concernant le contrôle, le rythme et la satisfaction des joueurs.
Si un modèle ennemi apprend aussi Il découvre efficacement des boucles de combat imbattables, des routines de ciblage au pixel près et des tactiques de suppression instantanée qui frustrent les joueurs.
Les concepteurs de jeux doivent mettre en place des garde-fous comportementaux stricts pour limiter l'efficacité de l'IA, afin de garantir que les adversaires restent un défi sans devenir injustes ou ennuyeux.
Les développeurs utilisent des courbes d'utilité, des délais de réaction intentionnels et des probabilités d'échec pour que les modèles neuronaux avancés restent amusants à utiliser.
L'équilibrage des moteurs de décision dynamiques nécessite des tests rigoureux afin d'éviter les bugs comportementaux inattendus ou les routines de combat qui compromettent le bon déroulement du jeu.
Trouver le juste équilibre entre une intelligence numérique authentique et un retour d'information satisfaisant propre aux jeux d'arcade reste le principal défi des concepteurs de jeux modernes.
Analyse comparative : scripts statiques vs. IA d’apprentissage automatique
La transition structurelle des pipelines de scripts déterministes vers des modèles comportementaux adaptatifs transforme la façon dont les adversaires numériques réagissent aux décisions des joueurs.
Le tableau ci-dessous détaille les différences opérationnelles entre les machines à états finis traditionnelles et les réseaux de politiques entraînés modernes, selon les dimensions fondamentales du gameplay.
| Fonctionnalités de jeu | Machines à états finis traditionnelles | Réseaux comportementaux d'apprentissage automatique |
| Recherche de chemin et navigation | Nœuds de points de passage fixes, lignes de grille rigides | Évaluation dynamique de la géométrie spatiale, parcours en temps réel |
| Adaptation au combat | Conditions de déclenchement prédéfinies | Mises à jour continues des politiques en fonction des tactiques des joueurs en direct |
| Coordination de l'équipe | Données de télémétrie partagées (lecture murale) | Relais de capteurs localisés, partage d'informations authentiques |
| Logique de recherche furtive | boucles de patrouille linéaires, cônes de vision fixes | Cartes thermiques probabilistes, recherche spatiale prédictive |
| mémoire à long terme | Réinitialisation de l'état lors de la mort/réapparition du joueur | Rétention de poids persistante au cours de plusieurs séances de jeu |
| Flux de travail de développement | Codage manuel de chaque branche de décision | Formation automatisée par scénarios via des boucles de renforcement |
L'aube des adversaires numériques vivants
L'intégration de apprentissage automatique L'entrée dans la conception des jeux modernes marque un changement fondamental, passant de cibles numériques prévisibles à des adversaires vivants et réalistes.
À mesure que les modèles d'entraînement neuronal gagnent en maturité et que les pipelines d'inférence dans le cloud deviennent transparents, les mondes de jeu présenteront des écosystèmes qui observent, s'adaptent et évoluent en fonction des stratégies des joueurs.
Cette technologie change fondamentalement la façon dont les joueurs abordent les défis tactiques, transformant les campagnes statiques en batailles dynamiques d'intelligence et d'adaptation.
Les développeurs de jeux ont le pouvoir de créer des mondes virtuels qui mettent les joueurs au défi sans avoir recours à des bonus de statistiques artificiels ou à des hacks de vision à travers les murs automatisés et bon marché.
Les joueurs ne pourront plus venir à bout des affrontements de haut niveau en mémorisant les itinéraires de patrouille ou en exploitant des failles géométriques ; la victoire exigera une véritable flexibilité tactique et une résolution créative des problèmes.
À mesure que ces systèmes adaptatifs évoluent, partagez vos expériences dans les commentaires sur la façon dont les interactions avec l'IA intelligente ont modifié vos moments de jeu préférés.
Questions fréquemment posées
Les modèles comportementaux avancés des ennemis rendront-ils les futurs jeux vidéo trop difficiles pour les joueurs occasionnels ?
Non, les développeurs mettent en œuvre des systèmes de mise à l'échelle de la difficulté personnalisables qui ajustent la latence de réponse, la précision et l'agressivité tactique des modèles entraînés.
Plutôt que de s'appuyer uniquement sur des multiplicateurs de dégâts bruts, les curseurs de difficulté modifient la vitesse à laquelle les réseaux neuronaux analysent les actions du joueur et exécutent des contre-stratégies, garantissant ainsi des expériences accessibles à tous les niveaux de compétence.
L'implémentation de l'inférence neuronale en temps réel a-t-elle un impact négatif sur la fréquence d'images des consoles modernes ?
Les plateformes matérielles modernes utilisent des blocs de traitement neuronal dédiés pour exécuter efficacement des modèles d'inférence légers parallèlement aux pipelines de rendu.
En utilisant des réseaux neuronaux optimisés, les moteurs de jeu traitent des décisions comportementales complexes dans des délais très courts (en microsecondes), préservant ainsi une fréquence d'images fluide même lors de combats intenses.
Comment les développeurs de jeux peuvent-ils empêcher les ennemis adaptatifs de découvrir des stratégies de combat imbattables ?
Les concepteurs intègrent des conditions limites strictes, des plafonds d'utilisation et des délais de réaction intentionnels dans la fonction de récompense afin de restreindre les capacités des agents.
Ces contraintes délibérées empêchent les modèles d'exploiter des avantages mécaniques tels qu'une visée parfaite, des vitesses de rotation instantanées ou des boucles de suppression infinies, ce qui rend les combats intéressants et équitables.
Les systèmes de comportement adaptatif des ennemis peuvent-ils fonctionner dans les jeux hors ligne sans connexion Internet active ?
Oui, les développeurs entraînent des modèles de réseaux neuronaux complexes lors de la production du jeu sur des serveurs cloud haute performance, puis compressent la politique finale entraînée dans un fichier d'exécution léger.
Le matériel local lit ce fichier de modèle pré-entraîné hors ligne, permettant un comportement adaptatif sophistiqué sans nécessiter de connexions serveur actives ni de diffusion en continu sur Internet.
En quoi l'apprentissage par renforcement diffère-t-il des scripts de programmation de jeux traditionnels ?
La programmation de jeux traditionnelle repose sur le travail manuel des développeurs humains qui écrivent chaque instruction conditionnelle, règle et arbre de décision pour un agent ennemi.
L'apprentissage par renforcement fournit à un agent des objectifs, des contraintes environnementales et un système de récompense, permettant au système de découvrir des manœuvres tactiques optimales grâce à des millions d'itérations d'auto-apprentissage.
