
Cómo el aprendizaje automático podría cambiar el comportamiento de los enemigos en los juegos futuros
Anuncios
Aprendizaje automático está transformando la forma en que los personajes no jugadores observan, se adaptan y reaccionan a las estrategias de juego modernas en entornos digitales complejos.
Los jugadores han pasado décadas explotando árboles de comportamiento estáticos, rutinas de búsqueda de rutas predecibles e inteligencia artificial de guardias telepática que se reinicia en el momento en que expira un temporizador.
Los motores de juego modernos están superando por fin las rígidas limitaciones de los guiones para construir ecosistemas receptivos que aprenden directamente de las decisiones del jugador.
El diseño tradicional de enemigos se basa en gran medida en máquinas de estados codificadas de forma rígida, donde los desarrolladores programan manualmente cada rama de decisión, límite y condición.
Cuando los jugadores descubren una laguna en esos guiones estáticos, la ilusión de desafío se desvanece al instante, haciendo que el juego parezca trivial.
Anuncios
Los algoritmos dinámicos permiten a los desarrolladores entrenar redes neuronales con millones de interacciones de jugadores, creando oponentes que ajustan sus tácticas en tiempo real.
Lo que explorarás en este artículo
- ¿Qué es el aprendizaje automático en el diseño de videojuegos?
- ¿Cómo reemplazan las redes neuronales a los scripts estáticos?
- ¿Por qué los guiones tradicionales para enemigos no convencen a los jugadores modernos?
- ¿Cómo entrena el aprendizaje por refuerzo a los oponentes virtuales?
- ¿Cómo transforma el comportamiento dinámico los sistemas de combate dinámicos?
- ¿Por qué las tácticas de flanqueo adaptativas están reemplazando a las patrullas fijas?
- ¿Cómo pueden los escuadrones controlados por la IA coordinar tácticas sin hacer trampas?
- ¿Qué papel desempeña la búsqueda predictiva de rutas en los juegos de sigilo?
- ¿Qué le depara el futuro a la inteligencia enemiga de próxima generación?
- ¿Por qué es esencial la memoria procedimental para los rivales persistentes?
- ¿Cómo procesará la computación en la nube los modelos de comportamiento en tiempo real?
- ¿Cuáles son los límites arquitectónicos de los sistemas de IA impredecibles?
- Análisis comparativo: Scripts estáticos frente a IA de aprendizaje automático
- El amanecer de los adversarios digitales vivientes
- Preguntas frecuentes
¿Qué es el aprendizaje automático en el diseño de videojuegos?
¿Cómo reemplazan las redes neuronales a los scripts estáticos?
Avanzado aprendizaje automático Los marcos de trabajo reemplazan los bucles condicionales "si-entonces" con redes de políticas flexibles que evalúan continuamente los vectores de estado del juego en tiempo real.
En lugar de seguir líneas de código rígidas escritas por los diseñadores, estos sistemas evalúan simultáneamente la distancia, la línea de visión, las reservas de salud y las opciones de armas para seleccionar las contraestrategias óptimas.
Este cambio fundamental transforma los objetivos digitales estáticos en oponentes flexibles que analizan los patrones de combate y ajustan su posicionamiento dinámicamente durante los encuentros activos.
La implementación requiere entrenar los modelos con vastos conjuntos de datos sobre el movimiento de los jugadores, la gestión de recursos y el posicionamiento táctico para establecer parámetros de comportamiento básicos.
Los desarrolladores introducen escenarios de combate simulados en sistemas de aprendizaje profundo, lo que permite al sistema refinar sus respuestas a lo largo de millones de batallas iterativas antes de su lanzamiento.
El agente de ejecución final utiliza modelos de inferencia ligeros para procesar las entradas del jugador al instante, manteniendo una velocidad de fotogramas fluida a la vez que toma decisiones inteligentes y contextuales.
¿Por qué los guiones tradicionales para enemigos no convencen a los jugadores modernos?
Los guiones convencionales para los enemigos se basan en máquinas de estados finitos deterministas que colapsan bajo el peso de las estrategias creativas e impredecibles de los jugadores.
Los jugadores experimentados memorizan rápidamente las rutas de patrulla, los conos de visión y los intervalos de ataque, lo que reduce los encuentros de combate de alto riesgo a rompecabezas espaciales repetitivos.
Una vez que un jugador descubre un punto ciego no previsto o una vulnerabilidad en la geometría de búsqueda de rutas, el desafío artificial desaparece por completo.
Los enemigos programados también sufren una división artificial entre el seguimiento omnisciente y la ceguera total, alternando a menudo entre ambos estados instantáneamente.
O bien poseen un conocimiento sobrenatural de las coordenadas exactas del jugador mediante la lectura de la geometría de las paredes, o bien permanecen ajenos a lo que sucede mientras los aliados caen cerca.
Este modelo operativo binario rompe la inmersión del jugador, poniendo de manifiesto las limitaciones mecánicas de la arquitectura de juegos tradicional.
++ El futuro de los juegos de mundo compartido más allá de la fórmula MMO.
¿Cómo entrena el aprendizaje por refuerzo a los oponentes virtuales?
Los modelos de aprendizaje por refuerzo utilizan funciones de recompensa para incentivar a los oponentes virtuales a alcanzar objetivos estratégicos como el control espacial, la ejecución de flancos y la supervivencia.
Los agentes digitales reciben retroalimentación matemática positiva cuando logran cortar las rutas de escape de los jugadores o preservar la salud del escuadrón durante los tiroteos.
Mediante millones de iteraciones de juego autónomo en entornos simulados, los agentes descubren de forma natural maniobras tácticas sofisticadas sin necesidad de instrucciones explícitas por parte del desarrollador.
Sony AI demostró este potencial transformador al desarrollar Gran Turismo Sophy de Sony AI, un agente entrenado mediante aprendizaje por refuerzo profundo que dominó la dinámica compleja de los vehículos, las trayectorias de carrera y el posicionamiento defensivo para derrotar a los mejores campeones humanos de deportes electrónicos.
En lugar de recibir rutas de conducción predefinidas, Sophy aprendió los puntos de frenado óptimos y las técnicas de adelantamiento tácticas mediante un proceso continuo de ensayo y error.
La aplicación de arquitecturas de entrenamiento similares a los juegos de acción permite que los enemigos aprendan mecánicas de combate complejas con una precisión casi humana.
¿Cómo transforma el comportamiento dinámico los sistemas de combate dinámicos?
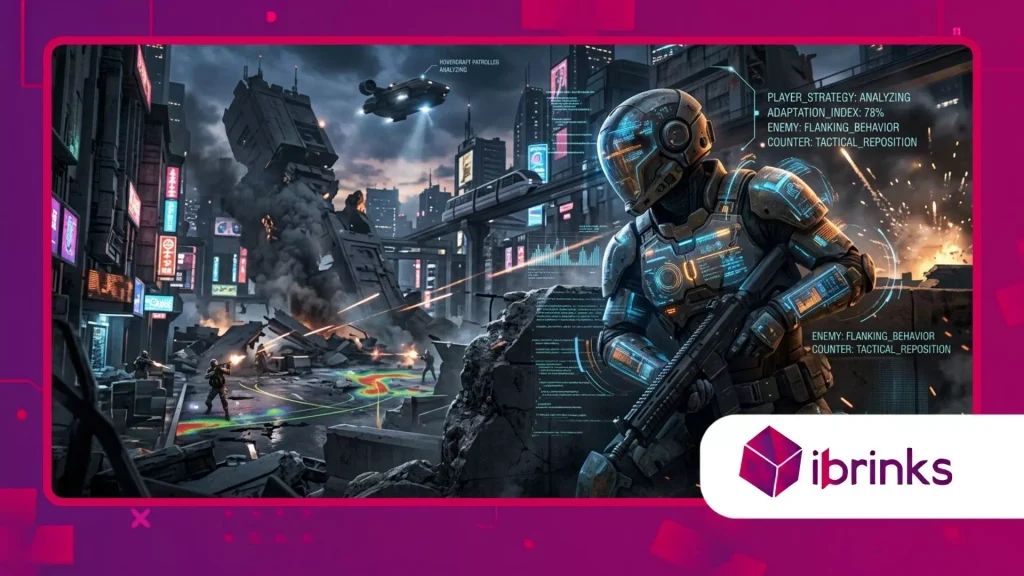
¿Por qué las tácticas de flanqueo adaptativas están reemplazando a las patrullas fijas?
Los combates modernos requieren adversarios adaptables que ajusten su movimiento espacial en función de la posición del jugador, la disponibilidad de cobertura y la supresión de armas.
En lugar de correr a lo largo de nodos de cobertura predefinidos, los enemigos, impulsados por modelos dinámicos, evalúan la geometría del terreno en tiempo real para localizar ángulos de disparo ventajosos.
Esta evolución estructural obliga a los jugadores a abandonar las estrategias de defensa estática, ya que los oponentes digitales se mueven activamente alrededor de las coberturas para romper las posiciones defensivas.
Los agentes adaptativos analizan el alcance de las armas, los ciclos de recarga y la exposición a la línea de visión para ejecutar tácticas de presión multifacéticas sin intervención del diseñador.
Cuando un jugador concentra el fuego en una dirección, las unidades que lo flanquean identifican el punto ciego visual y avanzan por los canales suprimidos.
Este movimiento fluido crea escenarios de combate orgánicos donde las líneas de batalla cambian dinámicamente en función del rendimiento del jugador, en lugar de depender de activadores predefinidos.
Lea también: El auge de las hojas de ruta impulsadas por la comunidad que reemplazan los planes de desarrollo fijos.
¿Cómo pueden los escuadrones controlados por la IA coordinar tácticas sin hacer trampas?
Los juegos clásicos a menudo simulaban la inteligencia de grupo proporcionando a los miembros del escuadrón datos de telemetría compartidos, lo que les permitía rastrear a los jugadores a través de superficies sólidas.
Moderno aprendizaje automático Estos modelos permiten una coordinación de escuadrones auténtica mediante protocolos de comunicación localizados, imitando a las unidades tácticas del mundo real que comparten datos de línea de visión propios de su perspectiva.
Los enemigos reaccionan únicamente a la información verificada por sus propios sensores visuales o acústicos, lo que garantiza el juego limpio a la vez que demuestra una sofisticada estrategia de equipo.
Los modelos de escuadrones coordinados distribuyen dinámicamente las funciones tácticas, asignando fuego de supresión, cobertura de retirada y maniobras de flanqueo en función del estado y el armamento de la unidad.
Si una unidad pesada avanza con un escudo, los fusileros de apoyo se cubren automáticamente detrás de la armadura que avanza para presionar la posición del jugador.
Esta coordinación emergente se percibe auténtica porque cada unidad actúa basándose en datos de campo fidedignos, en lugar de recurrir a trucos programáticos baratos.
Leer más: Cómo los juegos modernos equilibran la libertad con la guía sin llevar de la mano.
¿Qué papel desempeña la búsqueda predictiva de rutas en los juegos de sigilo?
La mecánica de juego de sigilo cambia drásticamente cuando los algoritmos de búsqueda reemplazan los circuitos de patrulla lineales con mapas de calor probabilísticos derivados de los hábitos del jugador.
En lugar de seguir rutas fijas, los modelos de búsqueda predictiva evalúan las brechas en la línea de visión, las puertas abiertas y las huellas de ruido para estimar dónde se esconden los jugadores que intentan pasar desapercibidos.
Los enemigos concentran sus esfuerzos de investigación en los escondites con mayor probabilidad de ser detectados, convirtiendo las fases de búsqueda rutinarias en tensas maniobras de evasión táctica.
Los algoritmos predictivos de búsqueda de rutas calculan posibles vectores de movimiento en función del tiempo que un jugador ha estado fuera de contacto visual directo.
Si se activa una alarma en el perímetro, los guardias calculan la distancia máxima que un jugador podría recorrer dentro de ese lapso de tiempo y establecen perímetros de búsqueda en consecuencia.
¿Te has preguntado alguna vez lo aterradores que se vuelven los encuentros sigilosos cuando los guardias anticipan activamente tu ruta de escape en lugar de seguir rastros de información?
¿Qué le depara el futuro a la inteligencia enemiga de próxima generación?
¿Por qué es esencial la memoria procedimental para los rivales persistentes?
Los sistemas de rivalidad persistente utilizan arquitecturas de memoria a largo plazo para conservar registros de los estilos de juego de los jugadores, sus armas favoritas y sus tendencias de combate a lo largo de campañas extensas.
Cuando un enemigo sobrevive a un encuentro, su modelo subyacente actualiza sus ponderaciones de decisión para contrarrestar las tácticas específicas que lo derrotaron previamente.
Si un jugador depende en gran medida de rifles de francotirador de largo alcance, los rivales que regresan aparecen con granadas de humo, armadura pesada y tácticas de ataque cuerpo a cuerpo.
La memoria procedimental transforma los encuentros recurrentes con enemigos, que antes eran simples comprobaciones de estadísticas, en rivalidades personales en constante evolución que reflejan la historia del jugador.
Los adversarios recuerdan las cicatrices físicas, las derrotas tácticas y los escapes por los pelos, lo que altera sus respuestas verbales y su comportamiento en combate durante los enfrentamientos posteriores.
Esta continuidad histórica profundiza el compromiso de los jugadores a largo plazo, ya que cada victoria táctica modifica el panorama general de amenazas.
¿Cómo procesará la computación en la nube los modelos de comportamiento en tiempo real?
La ejecución de modelos complejos de inferencia de redes neuronales junto con la renderización de gráficos de alta gama genera graves cuellos de botella en el rendimiento del hardware de la consola local.
La arquitectura basada en la nube resuelve esta limitación de procesamiento ejecutando modelos de comportamiento intensivos en servidores remotos y transmitiendo decisiones tácticas optimizadas al cliente del juego.
Esto libera a los procesadores locales de los cálculos complejos de álgebra lineal, lo que permite a los desarrolladores desplegar facciones enemigas masivas y altamente inteligentes sin comprometer la velocidad de fotogramas.
Las redes distribuidas de computación en la nube permiten que miles de instancias de juego activas envíen continuamente datos anonimizados sobre las decisiones de los jugadores a un modelo centralizado.
Mientras millones de jugadores prueban nuevos trucos en todo el mundo, la red centralizada actualiza las contraestrategias enemigas en tiempo real para toda la base de jugadores.
Este ciclo continuo de datos garantiza que la inteligencia enemiga evolucione a la par de las estrategias de la comunidad global, evitando el estancamiento del metajuego.
¿Cuáles son los límites arquitectónicos de los sistemas de IA impredecibles?
La integración de modelos de comportamiento autónomos en juegos narrativos estructurados plantea serios desafíos de diseño de juegos en lo que respecta al control, el ritmo y la satisfacción del jugador.
Si un modelo enemigo aprende también De manera eficiente, descubre bucles de combate imbatibles, rutinas de puntería de precisión milimétrica y tácticas de supresión instantáneas que frustran a los jugadores.
Los diseñadores de juegos deben establecer límites de comportamiento estrictos para restringir la eficacia de la IA, garantizando que los oponentes sigan siendo un desafío sin volverse injustos o aburridos.
Los desarrolladores utilizan curvas de utilidad, retrasos de reacción intencionados y probabilidades de fallo para que los modelos neuronales avanzados resulten entretenidos e interesantes.
El equilibrio de los motores de decisión dinámicos requiere pruebas rigurosas para prevenir errores de comportamiento inesperados o rutinas de combate que arruinen el juego.
Lograr el delicado equilibrio entre la inteligencia digital auténtica y la respuesta satisfactoria de las máquinas recreativas sigue siendo el principal desafío para los arquitectos de videojuegos modernos.
Análisis comparativo: Scripts estáticos frente a IA de aprendizaje automático
La transición estructural de los sistemas de scripts deterministas a los modelos de comportamiento adaptativos transforma la forma en que los adversarios digitales reaccionan a las decisiones de los jugadores.
La tabla que aparece a continuación detalla las diferencias operativas entre las máquinas de estados finitos tradicionales y las redes neuronales modernas entrenadas en función de las dimensiones principales del juego.
| Característica de juego | Máquinas de estados finitos tradicionales | Redes de comportamiento de aprendizaje automático |
| Búsqueda de rutas y navegación | Nodos de punto de referencia fijos, líneas de cuadrícula rígidas | Evaluación dinámica de la geometría espacial, recorrido en tiempo real. |
| Adaptación al combate | Condiciones de activación predefinidas | Actualizaciones continuas de las políticas basadas en las tácticas de los jugadores en tiempo real. |
| Coordinación de escuadrones | Datos de telemetría compartidos (lectura de pared) | Retransmisión de sensores localizada, intercambio de información auténtica |
| Lógica de búsqueda sigilosa | Bucles de patrulla lineales, conos de visión fija | Mapas de calor probabilísticos, búsqueda espacial predictiva |
| Memoria a largo plazo | Restablecer el estado al morir/reaparecer el jugador. | Retención de peso persistente a lo largo de varias sesiones de juego. |
| Flujo de trabajo de desarrollo | Codificación manual de cada rama de decisión | Entrenamiento automatizado basado en escenarios mediante bucles de refuerzo. |
El amanecer de los adversarios digitales vivientes
La integración de aprendizaje automático El diseño de videojuegos moderno supone un cambio fundamental, pasando de objetivos digitales predecibles a oponentes vivos y reales.
A medida que los modelos de entrenamiento neuronal maduren y los sistemas de inferencia en la nube se vuelvan más fluidos, los mundos de los juegos contarán con ecosistemas que observarán, se adaptarán y evolucionarán junto con las estrategias de los jugadores.
Esta tecnología cambia radicalmente la forma en que los jugadores abordan los desafíos tácticos, transformando las campañas estáticas en batallas dinámicas de inteligencia y adaptación.
Los desarrolladores de videojuegos tienen el poder de crear mundos virtuales que desafíen a los jugadores sin recurrir a mejoras artificiales de estadísticas ni a trucos programáticos baratos para atravesar paredes.
Los jugadores ya no superarán los encuentros de alto nivel memorizando rutas de patrulla o explotando nodos geométricos defectuosos; la victoria requerirá una auténtica flexibilidad táctica y una resolución creativa de problemas.
A medida que estos sistemas adaptativos evolucionan, comparte tus experiencias en los comentarios sobre cómo los encuentros con IA inteligente han cambiado tus momentos favoritos de juego.
Preguntas frecuentes
¿Los modelos avanzados de comportamiento de los enemigos harán que los videojuegos futuros sean demasiado difíciles para los jugadores ocasionales?
No, los desarrolladores implementan sistemas de escalado de dificultad personalizables que ajustan la latencia de respuesta, la precisión y la agresividad táctica de los modelos entrenados.
En lugar de depender únicamente de multiplicadores de daño brutos, los controles deslizantes de dificultad modifican la rapidez con la que las redes neuronales analizan las acciones del jugador y ejecutan contraestrategias, lo que garantiza experiencias accesibles para todos los niveles de habilidad.
¿La implementación de inferencia neuronal en tiempo real perjudica la velocidad de fotogramas del sistema en las consolas modernas?
Las plataformas de hardware modernas utilizan bloques de procesamiento neuronal dedicados para ejecutar modelos de inferencia ligeros de manera eficiente junto con los procesos de renderizado.
Mediante el uso de redes neuronales optimizadas, los motores de juego procesan decisiones de comportamiento complejas en intervalos de microsegundos muy ajustados, lo que permite mantener una velocidad de fotogramas fluida durante escenarios de combate intensos.
¿Cómo evitan los desarrolladores de videojuegos que los enemigos adaptativos descubran estrategias de combate invencibles?
Los diseñadores instalan condiciones límite estrictas, límites de utilidad y retrasos de reacción intencionados dentro de la función de recompensa para restringir las capacidades del agente.
Estas restricciones deliberadas impiden que los modelos exploten ventajas mecánicas como la puntería perfecta, los giros instantáneos o los bucles de supresión infinitos, lo que mantiene los encuentros de combate interesantes y justos.
¿Pueden funcionar los sistemas de comportamiento adaptativo de los enemigos en juegos sin conexión a internet?
Sí, los desarrolladores entrenan modelos complejos de redes neuronales durante la producción del juego en servidores en la nube de alto rendimiento y, a continuación, comprimen la política final entrenada en un archivo de ejecución ligero.
El hardware local lee este archivo de modelo preentrenado sin conexión, lo que permite un comportamiento adaptativo sofisticado sin necesidad de conexiones activas al servidor ni transmisión por Internet.
¿En qué se diferencia el aprendizaje por refuerzo de los scripts de programación de juegos tradicionales?
La programación de videojuegos tradicional se basa en que los desarrolladores humanos escriban manualmente cada instrucción condicional, regla y árbol de decisiones para un agente enemigo.
El aprendizaje por refuerzo proporciona al agente objetivos, restricciones ambientales y un sistema de recompensas, lo que permite al sistema descubrir maniobras tácticas óptimas a través de millones de iteraciones de autoaprendizaje.
