
機器學習如何改變未來遊戲中敵人的行為
廣告
機器學習 正在改變非玩家角色在複雜的數位環境中觀察、適應和應對現代遊戲策略的方式。
幾十年來,玩家一直在利用靜態行為樹、可預測的尋路程序以及在計時器到期時重置的心靈感應守衛人工智慧。
現代遊戲引擎終於擺脫了僵化的腳本限制,建構出能夠直接從玩家決策中學習的響應式生態系統。
傳統敵人設計嚴重依賴硬編碼狀態機,開發人員需要手動編寫每個決策分支、限制和條件。
當玩家發現這些靜態腳本中的漏洞時,挑戰的假象會立即破滅,使遊戲顯得微不足道。
廣告
動態演算法使開發人員能夠利用數百萬次玩家互動來訓練神經網絡,從而創造出能夠即時調整戰術的對手。
本文將探討的內容
- 什麼是遊戲設計中的機器學習?
- 神經網路如何取代靜態腳本?
- 為什麼傳統的敵方腳本無法滿足現代玩家的需求?
- 強化學習如何訓練虛擬對手?
- 動態行為如何重塑動態作戰系統?
- 為什麼自適應側翼戰術正在取代固定巡邏?
- NPC小隊如何在不作弊的情況下協調戰術?
- 預測路徑規劃在潛行遊戲中扮演什麼角色?
- 下一代敵方情報的發展前景如何?
- 為什麼程序性記憶對持久競爭者至關重要?
- 雲端運算將如何處理即時行為模型?
- 不可預測人工智慧系統的架構限制是什麼?
- 比較分析:靜態腳本與機器學習人工智慧
- 數字敵人的黎明
- 常見問題解答
什麼是遊戲設計中的機器學習?
神經網路如何取代靜態腳本?
先進的 機器學習 框架以靈活的策略網路取代條件「如果-那麼」循環,從而持續評估即時遊戲狀態向量。
這些系統不會遵循設計師編寫的僵化程式碼,而是同時評估距離、視線、生命值儲備和武器選擇,以選擇最佳的反制策略。
這種根本性的轉變將靜態的數位目標轉變為靈活的對手,這些對手能夠分析戰鬥模式,並在交戰過程中動態調整自身位置。
實施需要利用大量的球員移動、資源管理和戰術定位資料集來訓練模型,以建立基準行為參數。
開發人員將模擬戰鬥場景輸入深度學習流程,使系統能夠在發布前通過數百萬次的迭代戰鬥來改進其響應。
最終運行時代理使用輕量級推理模型即時處理玩家輸入,在保持流暢幀率的同時做出智能的、具有上下文感知能力的決策。
為什麼傳統的敵方腳本無法滿足現代玩家的需求?
傳統的敵人腳本依賴確定性的有限狀態機,而這些狀態機在富有創意、不可預測的玩家策略面前會崩潰。
經驗豐富的玩家能夠迅速記住巡邏路線、視野範圍和攻擊間隔,將高風險的戰鬥遭遇戰簡化為重複的空間謎題。
一旦玩家發現未預先設定的盲點或尋路幾何中的漏洞,人為的挑戰就會完全消失。
腳本化的敵人也存在著全知全能追蹤和完全失明之間的人為割裂,經常在兩種狀態之間瞬間切換。
他們要么擁有透過牆壁幾何形狀讀取玩家確切坐標的超自然知識,要么對附近倒下的盟友渾然不覺。
這種二元操作模式破壞了玩家的沉浸感,凸顯了傳統遊戲架構的機制限制。
強化學習如何訓練虛擬對手?
強化學習模型利用獎勵函數來激勵虛擬對手實現空間控制、側翼攻擊和生存等戰略目標。
數位代理商在成功切斷玩家逃生路線或在交火中保持小隊健康時會獲得積極的數學回饋。
透過在模擬環境中進行數百萬次的自我練習迭代,智能體無需開發者的明確指導,就能自然而然地發現複雜的戰術策略。
Sony AI 透過開發 Sony AI 的 Gran Turismo Sophy 展示了這種變革潛力。 Sophy 是一款透過深度強化學習訓練的智能體,它掌握了複雜的車輛動力學、賽車路線和防禦位置,從而擊敗了頂尖的人類電競冠軍。
Sophy 並沒有接受預先設定的駕駛路線,而是透過不斷的反覆試驗學習了最佳煞車點和戰術超車技巧。
將類似的訓練架構應用於動作遊戲,可以讓敵人以類似人類的精準度學習複雜的戰鬥機制。
動態行為如何重塑動態作戰系統?
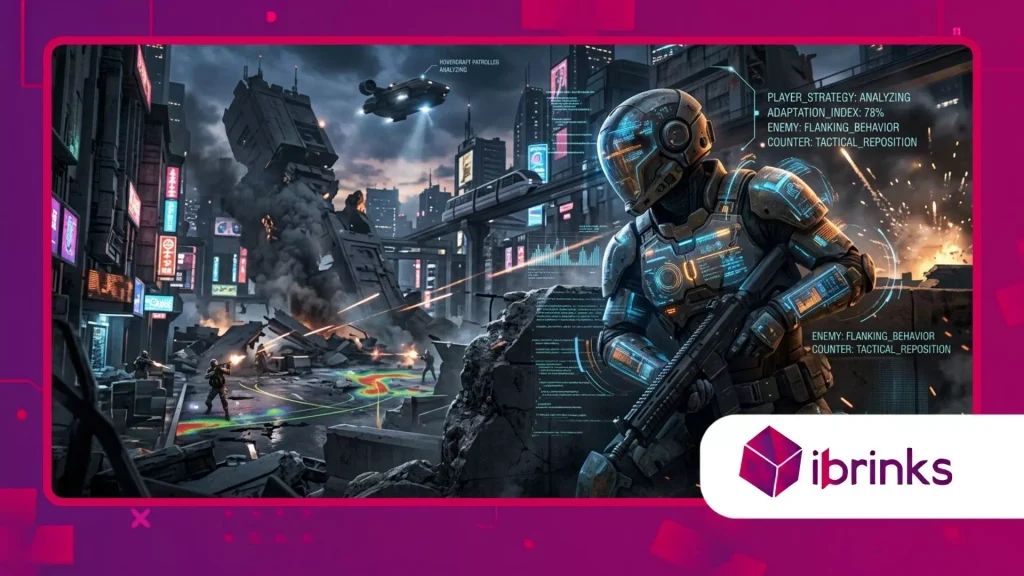
為什麼自適應側翼戰術正在取代固定巡邏?
現代戰爭中的敵人需要能夠根據玩家位置、掩體可用性和武器壓制情況調整其空間移動的適應性。
敵人不再沿著預先設定的掩體節點前進,而是由動態模型驅動,即時評估地形幾何形狀,以找到有利的射擊角度。
這種結構演變迫使玩家放棄靜態蹲守策略,因為數位對手會積極地繞著掩體移動,突破防禦陣地。
自適應代理會分析武器射程、裝填週期和視線暴露情況,以執行多管齊下的施壓戰術,而無需設計人員幹預。
當玩家集中火力向一個方向射擊時,側翼部隊會辨識出視覺盲區,並沿著被壓制的通道推進。
這種流暢的移動方式創造了自然的戰鬥場景,戰線會根據玩家的表現動態變化,而不是根據預先設定的觸發器而變化。
另請閱讀: 社區主導路線圖的興起取代了固定的發展計劃
NPC小隊如何在不作弊的情況下協調戰術?
傳統遊戲經常透過向小隊成員提供共享遙測數據來模擬團隊智慧,使他們能夠透過固體表面追蹤玩家。
現代的 機器學習 模型透過在地化的通訊協定實現真實的班組協調,模擬現實世界中的戰術單位共享與其視角相符的視線數據。
敵人僅根據自身視覺或聽覺感測器驗證的資訊做出反應,在保持公平競爭的同時,展現出複雜的團隊策略。
協調班組模型動態分配戰術角色,根據單位健康狀況和武器裝備分配壓制火力、撤退掩護和側翼機動。
如果重型單位帶著盾牌前進,支援步槍兵會自動躲在前進的裝甲部隊後面,向玩家的位置施壓。
這種湧現的協調讓人感覺真實可信,因為每個單位都依據可信的實地數據採取行動,而不是依靠廉價的程序作弊手段。
閱讀更多: 現代遊戲如何在不手把手指導的情況下平衡自由度和引導性
預測路徑規劃在潛行遊戲中扮演什麼角色?
當搜尋演算法以根據玩家習慣產生的機率熱圖取代線性巡邏循環時,潛行玩法會發生巨大變化。
預測搜尋模型不會沿著固定的路徑行進,而是評估視線突破、敞開的門和噪音痕跡,以估計隱藏玩家的藏身之處。
敵人將偵查精力集中在高機率藏身處,使例行搜索階段變成緊張的戰術規避。
預測路徑演算法根據玩家脫離直接視覺接觸的時間長短來計算潛在的移動向量。
如果警戒線附近響起警報,保全會計算玩家在規定時間內可能移動的最大距離,並據此劃定搜尋區域。
你有沒有想過,當守衛主動預測你的逃跑路線而不是追蹤你留下的線索時,潛行遭遇戰會變得多麼恐怖?
下一代敵方情報的發展前景如何?
為什麼程序性記憶對持久競爭者至關重要?
持久型對抗系統利用長期記憶架構來保留玩家在漫長戰役中的遊戲風格、喜愛的武器和戰鬥傾向的記錄。
當敵人在遭遇戰中倖存下來時,其底層模型會更新其決策權重,以應對先前擊敗它的特定戰術。
如果玩家嚴重依賴遠程狙擊步槍,那麼回歸的對手會攜帶煙霧彈、重甲和近距離突擊戰術。
程序記憶將反覆出現的敵人遭遇戰從重複的屬性檢查轉變為反映玩家歷史的不斷演變的個人對抗。
對手會記住身體上的傷痕、戰術上的失敗和死裡逃生,在隨後的對決中改變他們的言語回應和戰鬥行為。
這種歷史延續性加深了玩家的長期參與度,因為每一次戰術勝利都會重塑更廣泛的威脅環境。
雲端運算將如何處理即時行為模型?
同時執行複雜的神經網路推理模型和高階圖形渲染會為本地遊戲機硬體帶來嚴重的效能瓶頸。
雲端輔助架構透過在遠端伺服器上運行密集型行為模型並將優化的戰術決策串流回遊戲用戶端來解決這種運算限制。
這樣可以將繁重的線性代數計算從本地處理器卸載出去,使開發人員能夠部署龐大、高度智慧的敵方陣營,而不會影響幀速率。
分散式雲端運算網路允許數千個活躍的遊戲實例持續地將匿名化的玩家決策資料回饋到集中式模型中。
當全球數百萬玩家測試新的漏洞時,集中式網路會即時更新所有玩家的敵方反制策略。
這種持續的資料循環確保敵方情報與全球共同戰略同步發展,防止元遊戲停滯不前。
不可預測人工智慧系統的架構限制是什麼?
將自主行為模式融入結構化敘事遊戲中,在控制、節奏和玩家滿意度方面提出了嚴峻的遊戲設計挑戰。
如果敵方模型學習 也 它有效率地發現了無敵的戰鬥循環、像素級精準的瞄準程序和瞬間壓制戰術,讓玩家感到沮喪。
遊戲設計師必須建立嚴格的行為防護措施來限制人工智慧的效率,確保對手保持挑戰性,同時又不至於變得不公平或無趣。
開發者利用效用曲線、有意設定的反應延遲和失敗機率,讓高階神經網路模型保持趣味性。
平衡動態決策引擎需要嚴格的測試,以防止意想不到的行為錯誤或破壞遊戲平衡的戰鬥程序。
如何在真實的數位智慧和令人滿意的街機回饋之間找到微妙的平衡,仍然是現代遊戲設計師面臨的核心挑戰。
比較分析:靜態腳本與機器學習人工智慧
從確定性腳本管道到自適應行為模型的結構性轉變,改變了數位對手對玩家決策的反應。
下表詳細列出了傳統有限狀態機和現代訓練策略網路在核心遊戲玩法維度上的操作差異。
| 遊戲玩法特色 | 傳統有限狀態機 | 機器學習行為網絡 |
| 路徑規劃與導航 | 固定航點節點,剛性網格線 | 動態空間幾何評估,即時遍歷 |
| 戰鬥適應 | 預設觸發條件 | 根據球員即時戰術持續更新政策 |
| 小隊協調 | 共享遙測資料(牆讀) | 在地化感測器中繼,真實資訊分享 |
| 隱蔽搜尋邏輯 | 線性巡邏環,固定視錐 | 機率熱圖,預測性空間搜索 |
| 長期記憶 | 玩家死亡/重生後狀態重置 | 多次遊戲過程中體重持續保持穩定 |
| 開發工作流程 | 每個決策分支的手動編碼 | 透過強化循環進行自動化場景訓練 |
數字敵人的黎明
整合 機器學習 現代遊戲設計標誌著從可預測的數字目標轉向有生命、有呼吸的對手的根本性。
隨著神經訓練模式日趨成熟,雲推理管道日趨無縫,遊戲世界將擁有能夠觀察、適應和發展玩家策略的生態系統。
這項技術從根本上改變了玩家應對戰術挑戰的方式,將靜態戰役轉變為動態的智力與適應性戰鬥。
遊戲開發者有能力建構能夠挑戰玩家的虛擬世界,而無需訴諸人為的屬性提升或廉價的程式透視作弊手段。
玩家將不再透過記住巡邏路線或利用損壞的幾何節點來戰勝高等級敵人;勝利將需要真正的戰術靈活性和創造性的問題解決能力。
隨著這些自適應系統的不斷發展,請在評論區分享您的體驗,並說說智慧 AI 如何改變了您最喜歡的遊戲時刻。
常見問題解答
更先進的敵人行為模式是否會讓未來的電子遊戲對休閒玩家來說難度過高?
不,開發者實現了可自訂的難度縮放系統,可以調整訓練模型的反應延遲、準確性和戰術侵略性。
難度滑桿並非僅僅依靠原始傷害倍率,而是調整神經網路分析玩家行為和執行反制策略的速度,從而確保所有技能水平的玩家都能獲得良好的遊戲體驗。
在現代遊戲主機上實現即時神經推理會嚴重影響系統幀率嗎?
現代硬體平台利用專用神經處理模組,與渲染管線一起有效率地執行輕量級推理模型。
透過利用優化的神經網絡,遊戲引擎能夠在微秒級的預算內處理複雜的行為決策,從而在激烈的戰鬥場景中保持流暢的幀率。
遊戲開發者如何阻止具有適應性的敵人發現無敵的戰鬥策略?
設計者在獎勵函數中設定嚴格的邊界條件、效用上限和有意的反應延遲,以限制智能體的能力。
這些刻意設定的限制防止模型利用機械優勢,例如完美的瞄準、瞬間轉向速度或無限的壓制循環,從而保持戰鬥的趣味性和公平性。
自適應敵人行為系統能否在沒有網路連線的離線遊戲中正常運作?
是的,開發者在遊戲製作過程中會在高效能雲端伺服器上訓練複雜的神經網路模型,然後將最終訓練好的策略壓縮成輕量級的運行時檔案。
本地硬體可以離線讀取此預訓練模型文件,從而無需主動伺服器連接或互聯網流傳輸即可實現複雜的自適應行為。
強化學習與傳統遊戲程式腳本有何不同?
傳統遊戲程式設計依賴人類開發者手動編寫敵方智能體的每一個條件語句、規則和決策樹。
強化學習為智能體提供目標、環境限制和獎勵系統,使系統能夠透過數百萬次的自我博弈迭代來發現最佳戰術策略。
