
Como o aprendizado de máquina pode mudar o comportamento dos inimigos em jogos futuros
Anúncios
Aprendizado de máquina está transformando a maneira como os personagens não jogáveis observam, se adaptam e reagem às estratégias de jogos modernos em ambientes digitais complexos.
Os jogadores passaram décadas explorando árvores de comportamento estáticas, rotinas previsíveis de busca de caminhos e IA telepática de guardas que reinicia no momento em que um cronômetro expira.
Os motores de jogos modernos estão finalmente superando as rígidas restrições de roteiro para construir ecossistemas responsivos que aprendem diretamente com as decisões do jogador.
O design tradicional de inimigos depende muito de máquinas de estado codificadas, onde os desenvolvedores programam manualmente cada ramificação de decisão, limite e condição.
Quando os jogadores descobrem uma brecha nesses scripts estáticos, a ilusão de desafio se desfaz instantaneamente, fazendo com que o jogo pareça trivial.
Anúncios
Algoritmos dinâmicos permitem que os desenvolvedores treinem redes neurais com base em milhões de interações de jogadores, criando oponentes que ajustam suas táticas em tempo real.
O que você vai explorar neste artigo
- O que é aprendizado de máquina no design de jogos?
- Como as redes neurais substituem os scripts estáticos?
- Por que os roteiros tradicionais de inimigos falham com os jogadores modernos?
- Como o aprendizado por reforço treina oponentes virtuais?
- Como o comportamento dinâmico remodela os sistemas de combate dinâmicos?
- Por que as táticas de flanqueamento adaptativas estão substituindo as patrulhas fixas?
- Como esquadrões de NPCs podem coordenar táticas sem trapacear?
- Qual o papel da busca preditiva de caminhos em jogos de furtividade?
- O que o futuro reserva para a inteligência inimiga de próxima geração?
- Por que a memória procedural é essencial para rivais persistentes?
- Como a computação em nuvem processará modelos comportamentais em tempo real?
- Quais são os limites arquitetônicos dos sistemas de IA imprevisíveis?
- Análise comparativa: scripts estáticos vs. IA de aprendizado de máquina
- O alvorecer dos adversários digitais vivos
- Perguntas frequentes
O que é aprendizado de máquina no design de jogos?
Como as redes neurais substituem os scripts estáticos?
Avançado aprendizado de máquina As estruturas substituem os loops condicionais "se-então" por redes de políticas flexíveis que avaliam continuamente os vetores de estado do jogo em tempo real.
Em vez de seguirem linhas rígidas de código escritas por projetistas, esses sistemas avaliam simultaneamente a distância, a linha de visão, as reservas de saúde e as opções de armamento para selecionar as contra-estratégias ideais.
Essa mudança fundamental transforma alvos digitais estáticos em oponentes flexíveis que analisam padrões de combate e ajustam seu posicionamento dinamicamente durante confrontos ativos.
A implementação requer o treinamento de modelos em vastos conjuntos de dados sobre movimentação de jogadores, gerenciamento de recursos e posicionamento tático para estabelecer parâmetros comportamentais de referência.
Os desenvolvedores alimentam os sistemas de aprendizado profundo com cenários de combate simulados, permitindo que o sistema refine suas respostas ao longo de milhões de batalhas iterativas antes do lançamento.
O agente de tempo de execução final utiliza modelos de inferência leves para processar instantaneamente as entradas do jogador, mantendo taxas de quadros fluidas enquanto toma decisões inteligentes e contextualizadas.
Por que os roteiros tradicionais de inimigos falham com os jogadores modernos?
Os scripts inimigos convencionais dependem de máquinas de estado finito determinísticas que entram em colapso sob o peso de estratégias criativas e imprevisíveis dos jogadores.
Jogadores experientes memorizam rapidamente rotas de patrulha, cones de visão e intervalos de ataque, reduzindo confrontos de alto risco a quebra-cabeças espaciais repetitivos.
Assim que um jogador descobre um ponto cego não programado ou uma falha na geometria de busca de caminho, o desafio artificial desaparece completamente.
Os inimigos programados também sofrem de uma divisão artificial entre rastreamento onisciente e cegueira completa, alternando frequentemente entre os dois estados instantaneamente.
Ou eles possuem conhecimento sobrenatural das coordenadas exatas do jogador através da leitura da geometria das paredes, ou permanecem alheios enquanto aliados caem nas proximidades.
Esse modelo operacional binário quebra a imersão do jogador, evidenciando as limitações mecânicas da arquitetura de jogos tradicional.
++ O futuro dos jogos de mundo compartilhado além da fórmula MMO
Como o aprendizado por reforço treina oponentes virtuais?
Os modelos de aprendizado por reforço utilizam funções de recompensa para incentivar oponentes virtuais a atingirem objetivos estratégicos, como controle espacial, execução de flancos e sobrevivência.
Os agentes digitais recebem feedback matemático positivo quando bloqueiam com sucesso as rotas de fuga dos jogadores ou preservam a saúde do esquadrão durante tiroteios.
Por meio de milhões de iterações de jogo autônomo em ambientes simulados, os agentes descobrem naturalmente manobras táticas sofisticadas sem instruções explícitas do desenvolvedor.
A Sony AI demonstrou esse potencial transformador ao desenvolver a Sony AI Gran Turismo Sophy, uma agente treinada por meio de aprendizado por reforço profundo que dominou a dinâmica complexa de veículos, linhas de corrida e posicionamento defensivo para derrotar os melhores campeões humanos de e-sports.
Em vez de receber instruções de direção pré-definidas, Sophy aprendeu os pontos de frenagem ideais e as técnicas de ultrapassagem por meio de tentativas e erros contínuos.
Aplicar arquiteturas de treinamento semelhantes a jogos de ação permite que os inimigos aprendam mecânicas de combate complexas com uma precisão quase humana.
Como o comportamento dinâmico remodela os sistemas de combate dinâmicos?
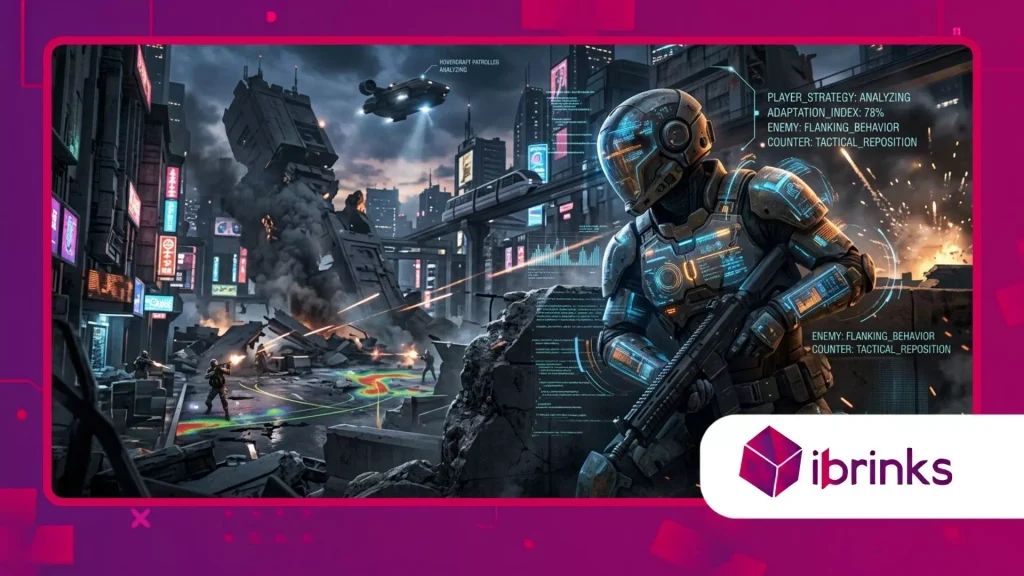
Por que as táticas de flanqueamento adaptativas estão substituindo as patrulhas fixas?
Os combates modernos exigem adversários adaptáveis que ajustem seus movimentos espaciais com base na posição do jogador, na disponibilidade de cobertura e na supressão de armas.
Em vez de se deslocarem ao longo de pontos de cobertura pré-definidos, os inimigos, impulsionados por modelos dinâmicos, avaliam a geometria do terreno em tempo real para localizar ângulos de disparo vantajosos.
Essa evolução estrutural força os jogadores a abandonar estratégias estáticas de acampamento, já que os oponentes digitais manobram ativamente ao redor das coberturas para romper as posições defensivas.
Agentes adaptativos analisam o alcance das armas, os ciclos de recarga e a exposição da linha de visão para executar táticas de pressão multifacetadas sem intervenção do projetista.
Quando um jogador concentra fogo em uma direção, as unidades de flanqueamento identificam o ponto cego visual e avançam pelos canais suprimidos.
Essa movimentação fluida cria cenários de combate orgânicos, onde as linhas de batalha mudam dinamicamente com base no desempenho do jogador, em vez de gatilhos pré-programados.
Leia também: A ascensão de roteiros elaborados pela comunidade em substituição aos planos de desenvolvimento fixos.
Como esquadrões de NPCs podem coordenar táticas sem trapacear?
Os jogos clássicos frequentemente simulavam a inteligência de grupo, fornecendo aos membros do esquadrão dados de telemetria compartilhados, permitindo-lhes rastrear jogadores através de superfícies sólidas.
Moderno aprendizado de máquina Os modelos permitem uma coordenação autêntica de esquadrões por meio de protocolos de comunicação localizados, imitando unidades táticas do mundo real que compartilham dados de linha de visão orgânicos à sua perspectiva.
Os inimigos reagem exclusivamente às informações verificadas por seus próprios sensores visuais ou acústicos, mantendo o jogo limpo e demonstrando, ao mesmo tempo, uma estratégia de equipe sofisticada.
Os modelos de esquadrão coordenados distribuem funções táticas dinamicamente, atribuindo fogo de supressão, cobertura de recuo e manobras de flanqueamento com base na saúde e no armamento da unidade.
Se uma unidade pesada avançar com um escudo, os fuzileiros de apoio automaticamente se abrigam atrás da blindagem que avança para pressionar a posição do jogador.
Essa coordenação emergente parece autêntica porque cada unidade age com base em dados de campo confiáveis, em vez de recorrer a truques programáticos baratos.
Leia mais: Como os jogos modernos equilibram liberdade e orientação sem dar tudo de mão beijada
Qual o papel da busca preditiva de caminhos em jogos de furtividade?
A jogabilidade furtiva muda drasticamente quando os algoritmos de busca substituem os circuitos de patrulha lineares por mapas de calor probabilísticos derivados dos hábitos do jogador.
Em vez de percorrerem caminhos predefinidos, os modelos de busca preditiva avaliam falhas na linha de visão, portas abertas e rastros de ruído para estimar onde os jogadores furtivos estão se escondendo.
Os inimigos concentram seus esforços de investigação em esconderijos de alta probabilidade, transformando fases de busca rotineiras em tensas manobras evasivas táticas.
Os algoritmos preditivos de busca de caminhos calculam vetores de movimento potenciais com base em quanto tempo um jogador esteve fora do alcance visual direto.
Se um alarme for acionado no perímetro, os guardas calculam a distância máxima que um jogador poderia percorrer dentro desse período e estabelecem perímetros de busca de acordo.
Você já se perguntou o quão aterrorizantes se tornam os encontros furtivos quando os guardas antecipam ativamente sua rota de fuga em vez de seguirem pistas superficiais?
O que o futuro reserva para a inteligência inimiga de próxima geração?
Por que a memória procedural é essencial para rivais persistentes?
Sistemas de rivalidade persistente utilizam arquiteturas de memória de longo prazo para reter registros dos estilos de jogo dos jogadores, armas favoritas e tendências de combate ao longo de campanhas prolongadas.
Quando um inimigo sobrevive a um confronto, seu modelo subjacente atualiza seus pesos de decisão para neutralizar as táticas específicas que o derrotaram anteriormente.
Se um jogador depende muito de rifles de precisão de longo alcance, os rivais que retornam surgem com granadas de fumaça, armaduras pesadas e táticas de ataque rápido em curta distância.
A memória procedural transforma encontros recorrentes com inimigos, de verificações repetitivas de atributos, em rivalidades pessoais em constante evolução que refletem a história do jogador.
Os adversários se lembram de cicatrizes físicas, derrotas táticas e fugas por pouco, o que altera suas respostas verbais e comportamento em combate durante confrontos subsequentes.
Essa continuidade histórica aprofunda o envolvimento dos jogadores a longo prazo, uma vez que cada vitória tática remodela o ambiente de ameaças mais amplo.
Como a computação em nuvem processará modelos comportamentais em tempo real?
A execução de modelos complexos de inferência de redes neurais em conjunto com a renderização gráfica de alta qualidade apresenta sérios gargalos de desempenho para o hardware de consoles locais.
A arquitetura assistida por nuvem resolve essa limitação computacional executando modelos comportamentais intensivos em servidores remotos e transmitindo decisões táticas otimizadas de volta para o cliente do jogo.
Isso descarrega os cálculos complexos de álgebra linear dos processadores locais, permitindo que os desenvolvedores implementem facções inimigas massivas e altamente inteligentes sem comprometer a taxa de quadros.
Redes de computação em nuvem distribuídas permitem que milhares de instâncias de jogos ativas alimentem continuamente um modelo centralizado com dados anonimizados de decisões de jogadores.
Enquanto milhões de jogadores testam novas vulnerabilidades globalmente, a rede centralizada atualiza as contra-estratégias inimigas em tempo real para toda a base de jogadores.
Esse ciclo contínuo de dados garante que a inteligência inimiga evolua juntamente com as estratégias da comunidade global, evitando a estagnação do metajogo.
Quais são os limites arquitetônicos dos sistemas de IA imprevisíveis?
A integração de modelos comportamentais autônomos em jogos narrativos estruturados apresenta desafios significativos de design de jogos em relação ao controle, ritmo e satisfação do jogador.
Se um modelo inimigo aprender também Com eficiência, ele descobre padrões de combate imbatíveis, rotinas de mira com precisão milimétrica e táticas de supressão instantânea que deixam os jogadores frustrados.
Os desenvolvedores de jogos devem criar diretrizes comportamentais rigorosas para limitar a eficiência da IA, garantindo que os oponentes permaneçam desafiadores sem se tornarem injustos ou pouco divertidos.
Os desenvolvedores utilizam curvas de utilidade, atrasos de reação intencionais e probabilidades de falha para manter os modelos neurais avançados interessantes e envolventes.
O balanceamento de mecanismos de decisão dinâmicos exige testes rigorosos para evitar erros comportamentais inesperados ou rotinas de combate que quebrem o jogo.
Encontrar o delicado equilíbrio entre inteligência digital autêntica e uma experiência arcade satisfatória continua sendo o principal desafio para os arquitetos de jogos modernos.
Análise comparativa: scripts estáticos vs. IA de aprendizado de máquina
A transição estrutural de fluxos de scripts determinísticos para modelos comportamentais adaptativos transforma a forma como os adversários digitais reagem às decisões dos jogadores.
A tabela abaixo detalha as diferenças operacionais entre máquinas de estado finito legadas e redes de políticas treinadas modernas em dimensões centrais do jogo.
| Recurso de jogabilidade | Máquinas de estado finito tradicionais | Redes Comportamentais de Aprendizado de Máquina |
| Busca de caminhos e navegação | Nós de ponto de referência fixos, linhas de grade rígidas | Avaliação dinâmica da geometria espacial, percurso em tempo real |
| Adaptação ao combate | Condições de ativação pré-definidas | Atualizações contínuas de políticas com base nas táticas dos jogadores em tempo real. |
| Coordenação de Equipe | Dados de telemetria compartilhados (leitura na parede) | Retransmissão de sensores localizados, compartilhamento de informações autênticas |
| Lógica de Busca Furtiva | Circuitos de patrulha lineares, cones de visão fixos | Mapas de calor probabilísticos, busca espacial preditiva |
| Memória de longo prazo | Redefinir estado ao morrer/renascer do jogador | Retenção persistente de peso ao longo de várias sessões de jogo. |
| Fluxo de trabalho de desenvolvimento | Codificação manual de cada ramo de decisão. | Treinamento automatizado de cenários por meio de ciclos de reforço. |
O alvorecer dos adversários digitais vivos
A integração de aprendizado de máquina A incorporação do design de jogos moderno marca uma mudança fundamental, afastando-se de alvos digitais previsíveis e aproximando-se de oponentes reais e interativos.
À medida que os modelos de treinamento neural amadurecem e os fluxos de trabalho de inferência em nuvem se tornam mais eficientes, os mundos dos jogos apresentarão ecossistemas que observam, se adaptam e evoluem juntamente com as estratégias dos jogadores.
Essa tecnologia muda fundamentalmente a forma como os jogadores abordam os desafios táticos, transformando campanhas estáticas em batalhas dinâmicas de inteligência e adaptação.
Os desenvolvedores de jogos têm o poder de construir mundos virtuais que desafiam os jogadores sem recorrer a melhorias artificiais de atributos ou truques baratos para atravessar paredes.
Os jogadores não irão mais derrotar inimigos de alto nível memorizando rotas de patrulha ou explorando falhas na geometria do ambiente; a vitória exigirá verdadeira flexibilidade tática e soluções criativas para os problemas.
À medida que esses sistemas adaptativos evoluem, compartilhe suas experiências nos comentários sobre como os encontros com IA inteligente alteraram seus momentos favoritos nos jogos.
Perguntas frequentes
Será que modelos avançados de comportamento inimigo tornarão os futuros jogos eletrônicos muito difíceis para jogadores casuais?
Não, os desenvolvedores implementam sistemas de escalonamento de dificuldade personalizáveis que ajustam a latência de resposta, a precisão e a agressividade tática dos modelos treinados.
Em vez de depender apenas de multiplicadores de dano brutos, os controles deslizantes de dificuldade modificam a rapidez com que as redes neurais analisam as ações do jogador e executam contra-estratégias, garantindo experiências acessíveis em todos os níveis de habilidade.
A implementação de inferência neural em tempo real prejudica a taxa de quadros do sistema em consoles modernos?
As plataformas de hardware modernas utilizam blocos de processamento neural dedicados para executar modelos de inferência leves de forma eficiente, juntamente com os fluxos de renderização.
Ao utilizar redes neurais otimizadas, os motores de jogos processam decisões comportamentais complexas dentro de orçamentos de microssegundos rigorosos, preservando taxas de quadros estáveis durante cenários de combate intensos.
Como os desenvolvedores de jogos impedem que inimigos adaptáveis descubram estratégias de combate invencíveis?
Os projetistas implementam condições de contorno rigorosas, limites de utilidade e atrasos de reação intencionais na função de recompensa para restringir as capacidades do agente.
Essas restrições deliberadas impedem que os modelos explorem vantagens mecânicas como mira perfeita, taxas de giro instantâneas ou ciclos infinitos de supressão, mantendo os encontros de combate envolventes e justos.
Sistemas adaptativos de comportamento inimigo podem funcionar em jogos offline sem conexão ativa com a internet?
Sim, os desenvolvedores treinam modelos complexos de redes neurais durante a produção do jogo em servidores de nuvem de alto desempenho e, em seguida, compactam a política treinada final em um arquivo de tempo de execução leve.
O hardware local lê esse arquivo de modelo pré-treinado offline, permitindo um comportamento adaptativo sofisticado sem a necessidade de conexões ativas com o servidor ou streaming pela internet.
Como o aprendizado por reforço difere dos scripts tradicionais de programação de jogos?
A programação de jogos tradicional depende de desenvolvedores humanos que escrevem manualmente cada declaração condicional, regra e árvore de decisão para um agente inimigo.
O aprendizado por reforço fornece ao agente objetivos, restrições ambientais e um sistema de recompensas, permitindo que o sistema descubra manobras táticas ótimas por meio de milhões de iterações de autojogo.
