
Hvordan maskinlæring kan endre fiendens oppførsel i fremtidige spill
Annonser
Maskinlæring forandrer hvordan ikke-spillbare karakterer observerer, tilpasser seg og reagerer på moderne spillstrategier på tvers av komplekse digitale miljøer.
Spillere har brukt flere tiår på å utnytte statiske atferdstrær, forutsigbare stifinnerutiner og telepatisk vakt-AI som tilbakestiller seg i det øyeblikket en timer utløper.
Moderne spillmotorer beveger seg endelig forbi rigide skriptbegrensninger for å bygge responsive økosystemer som lærer direkte av spillernes beslutninger.
Tradisjonell fiendedesign er sterkt avhengig av hardkodede tilstandsmaskiner der utviklere manuelt programmerer hver beslutningsgren, grense og betingelse.
Når spillere oppdager et smutthull i disse statiske skriptene, knuses illusjonen om utfordring umiddelbart, og spillet føles trivielt.
Annonser
Dynamiske algoritmer lar utviklere trene nevrale nettverk på millioner av spillerinteraksjoner, og skape motstandere som justerer taktikken sin i sanntid.
Hva du vil utforske i denne artikkelen
- Hva er maskinlæring i spilldesign?
- Hvordan erstatter nevrale nettverk statiske skript?
- Hvorfor svikter tradisjonelle fiendeskript moderne spillere?
- Hvordan trener forsterkningslæring virtuelle motstandere?
- Hvordan omformer dynamisk atferd dynamiske kampsystemer?
- Hvorfor erstatter adaptive flanketaktikker faste patruljer?
- Hvordan kan NPC-grupper koordinere taktikker uten å jukse?
- Hvilken rolle spiller prediktiv veifinning i snikspill?
- Hva ligger i vente for neste generasjons fiendens etterretning?
- Hvorfor er prosedyreminne viktig for vedvarende rivaler?
- Hvordan vil skytjenester behandle sanntids atferdsmodeller?
- Hva er de arkitektoniske begrensningene til uforutsigbare AI-systemer?
- Komparativ analyse: Statiske skript vs. maskinlæring med AI
- De levende digitale motstandernes begynnelse
- Ofte stilte spørsmål
Hva er maskinlæring i spilldesign?
Hvordan erstatter nevrale nettverk statiske skript?
Avansert maskinlæring Rammeverk erstatter betingede «hvis-så»-løkker med fleksible policynettverk som kontinuerlig evaluerer tilstandsvektorer i live-spill.
I stedet for å følge rigide kodelinjer skrevet av designere, evaluerer disse systemene avstand, siktlinje, helsereserver og våpenvalg samtidig for å velge optimale motstrategier.
Dette grunnleggende skiftet konverterer statiske digitale mål til fleksible motstandere som analyserer kampmønstre og justerer posisjoneringen sin dynamisk under aktive møter.
Implementeringen krever treningsmodeller på enorme datasett av spillerbevegelse, ressurshåndtering og taktisk posisjonering for å etablere grunnleggende atferdsparametere.
Utviklere mater simulerte kampscenarier inn i dyp læringsprosessen, slik at systemet kan forbedre responsene sine på tvers av millioner av iterative kamper før utgivelse.
Den endelige runtime-agenten bruker lette inferensmodeller for å behandle spillerinndata umiddelbart, og opprettholder flytende bildefrekvenser samtidig som den tar intelligente, kontekstbevisste beslutninger.
Hvorfor svikter tradisjonelle fiendeskript moderne spillere?
Konvensjonelle fiendtlige skript er avhengige av deterministiske endelige tilstandsmaskiner som kollapser under vekten av kreative, uforutsigbare spillerstrategier.
Erfarne spillere memorerer raskt patruljeruter, siktekjegler og angrepsintervaller, noe som reduserer kamper med høy innsats til repeterende romlige gåter.
Når en spiller oppdager en uskriptet blindsone eller en utnyttelse i stifinningsgeometrien, forsvinner den kunstige utfordringen helt.
Skriptbaserte fiender lider også av et kunstig skille mellom allvitende sporing og fullstendig blindhet, og bytter ofte mellom begge tilstandene umiddelbart.
De har enten overnaturlig kunnskap om spillerens nøyaktige koordinater gjennom vegggeometriavlesninger, eller de er uvitende mens allierte faller ned i nærheten.
Denne binære operasjonsmodellen bryter spillerens fordypning og fremhever de mekaniske begrensningene i tradisjonell spillarkitektur.
++ Fremtiden for spill med delte verdener utover MMO-formelen
Hvordan trener forsterkningslæring virtuelle motstandere?
Forsterkningslæringsmodeller bruker belønningsfunksjoner for å motivere virtuelle motstandere mot strategiske mål som romlig kontroll, flankeutførelse og overlevelse.
Digitale agenter får positiv matematisk tilbakemelding når de klarer å kutte av spilleres rømningsveier eller bevare troppens helse under skuddvekslinger.
Gjennom millioner av selvspill-iterasjoner i simulerte miljøer, oppdager agenter naturlig sofistikerte taktiske manøvrer uten eksplisitte instruksjoner fra utvikleren.
Sony AI demonstrerte dette transformative potensialet ved å utvikle Sony AIs Gran Turismo Sophy, en agent trent via dyp forsterkningslæring som mestret kompleks kjøretøydynamikk, racinglinjer og defensiv posisjonering for å beseire de beste menneskelige esportmesterne.
I stedet for å motta hardkodede kjøreveier, lærte Sophy optimale bremsepunkter og taktiske forbikjøringer gjennom kontinuerlig prøving og feiling.
Å bruke lignende treningsarkitekturer i actionspill gjør det mulig for fiender å lære komplekse kampmekanikker med menneskelignende presisjon.
Hvordan omformer dynamisk atferd dynamiske kampsystemer?
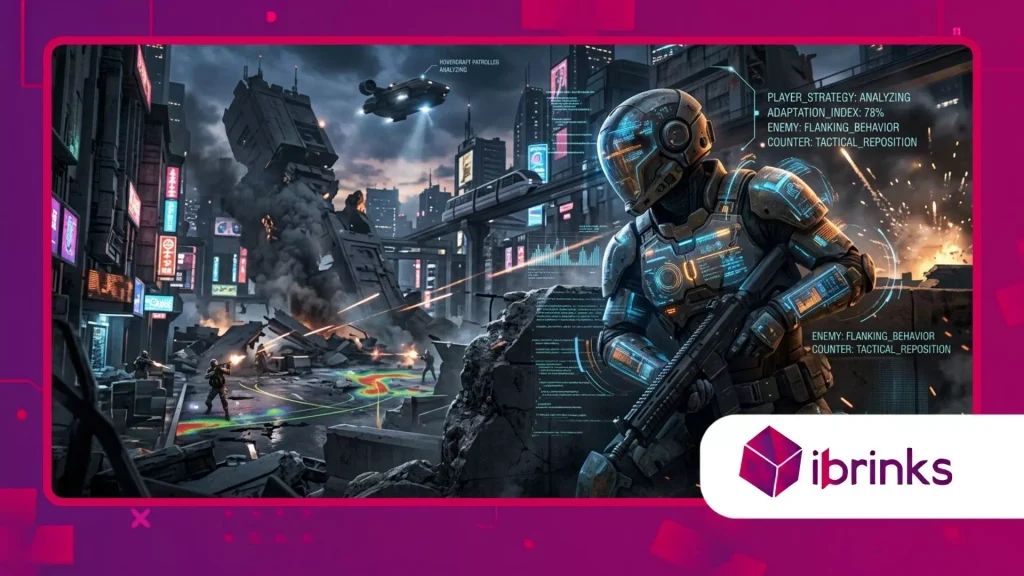
Hvorfor erstatter adaptive flanketaktikker faste patruljer?
Moderne kampmøter krever adaptive motstandere som justerer sin romlige bevegelse basert på spillerposisjon, tilgjengelighet av dekning og våpenundertrykkelse.
I stedet for å løpe langs forhåndsbygde dekningsnoder, evaluerer fiender drevet av dynamiske modeller terrenggeometri i sanntid for å finne fordelaktige skuddvinkler.
Denne strukturelle utviklingen tvinger spillere til å forlate statiske campingstrategier, ettersom digitale motstandere aktivt manøvrerer seg rundt dekning for å bryte gjennom defensive posisjoner.
Adaptive agenter analyserer våpenrekkevidder, ladesykluser og siktlinjeeksponering for å utføre flerleddspresstaktikker uten designerinnblanding.
Når en spiller fokuserer ild i én retning, identifiserer flankerende enheter den visuelle blindsonen og rykker frem langs undertrykte kanaler.
Denne flytende bevegelsen skaper organiske kampscenarier der kamplinjene endres dynamisk basert på spillerens ytelse i stedet for skriptede utløsere.
Les også: Fremveksten av fellesskapsdrevne veikart som erstatter faste utviklingsplaner
Hvordan kan NPC-grupper koordinere taktikker uten å jukse?
Eldre spill simulerte ofte gruppeintelligens ved å gi lagmedlemmer delte telemetri-data, slik at de kunne spore spillere gjennom solide overflater.
Moderne maskinlæring Modeller muliggjør autentisk troppskoordinering gjennom lokaliserte kommunikasjonsprotokoller, som etterligner virkelige taktiske enheter som deler siktlinjedata organisk til deres perspektiv.
Fiender reagerer utelukkende på informasjon bekreftet av sine egne visuelle eller akustiske sensorer, og opprettholder fair play samtidig som de demonstrerer sofistikert lagstrategi.
Koordinerte troppsmodeller fordeler taktiske roller dynamisk, og tildeler undertrykkende ild, retrettdekning og flankerende manøvrer basert på enhetens helse og våpen.
Hvis en tung enhet rykker frem med et skjold, vil støttende geværmenn automatisk søke dekning bak den fremrykkende rustningen for å legge press på spillerens posisjon.
Denne fremvoksende koordineringen føles autentisk fordi hver enhet handler basert på troverdige feltdata i stedet for billige programmatiske juksekoder.
Les mer: Hvordan moderne spill balanserer frihet kontra veiledning uten håndtak
Hvilken rolle spiller prediktiv veifinning i snikspill?
Stealth-spillingen endres dramatisk når søkealgoritmer erstatter lineære patruljeløkker med sannsynlighetsbaserte varmekart avledet fra spillervaner.
I stedet for å gå faste stier, evaluerer prediktive søkemodeller brudd i siktlinjen, åpne dører og støyavtrykk for å anslå hvor snikspillere gjemmer seg.
Fiender konsentrerer etterforskningsarbeidet sitt om skjulesteder med høy sannsynlighet, og forvandler rutinemessige søkefaser til anspente taktiske unnvikelser.
Prediktive stifinningsalgoritmer beregner potensielle bevegelsesvektorer basert på hvor lenge en spiller har vært ute av direkte visuell kontakt.
Hvis en alarm utløses på perimeteret, beregner vaktene den maksimale avstanden en spiller kan reise innenfor den tidsrammen og danner søkeperimetere deretter.
Har du noen gang lurt på hvor skremmende snikmøter blir når vakter aktivt forutser rømningsveien din i stedet for å følge brødsmulespor?
Hva ligger i vente for neste generasjons fiendens etterretning?
Hvorfor er prosedyreminne viktig for vedvarende rivaler?
Vedvarende rivalsystemer bruker langtidsminnearkitekturer for å beholde oversikt over spillernes spillestiler, favorittvåpen og kamptendenser på tvers av lengre kampanjer.
Når en fiende overlever et møte, oppdaterer den underliggende modellen beslutningsvektene for å motvirke de spesifikke taktikkene som beseiret den tidligere.
Hvis en spiller er veldig avhengig av langtrekkende snikskytterrifler, dukker tilbakevendende rivaler opp med røykgranater, tung rustning og nærkamptaktikker.
Prosedyreminne forvandler gjentakende fiendemøter fra repeterende statistikksjekker til utviklende personlige rivaliseringer som gjenspeiler spillerens historie.
Motstandere husker fysiske arr, taktiske nederlag og knappe unnslipp, og endrer sine verbale reaksjoner og kampatferd under påfølgende oppgjør.
Denne historiske kontinuiteten forsterker det langsiktige spillerengasjementet, ettersom hver taktiske seier omformer det bredere trusselmiljøet.
Hvordan vil skytjenester behandle sanntids atferdsmodeller?
Å kjøre komplekse slutningsmodeller for nevrale nettverk sammen med avansert grafikkgjengivelse presenterer alvorlige ytelsesflaskehalser for lokal konsollmaskinvare.
Skybasert arkitektur løser denne beregningsbegrensningen ved å kjøre intensive atferdsmodeller på eksterne servere og strømme optimaliserte taktiske beslutninger tilbake til spillklienten.
Dette avlaster tunge lineære algebraberegninger fra lokale prosessorer, slik at utviklere kan distribuere massive, svært intelligente fiendtlige fraksjoner uten å gå på kompromiss med bildefrekvensen.
Distribuerte skybaserte databehandlingsnettverk lar tusenvis av aktive spillforekomster kontinuerlig mate anonymiserte spillerbeslutningsdata tilbake til en sentralisert modell.
Etter hvert som millioner av spillere tester nye utnyttelser globalt, oppdaterer det sentraliserte nettverket fiendens motstrategier i sanntid på tvers av hele spillerbasen.
Denne kontinuerlige datasløyfen sikrer at fiendens etterretning utvikler seg sammen med globale samfunnsstrategier, og forhindrer stagnasjon i metaspillet.
Hva er de arkitektoniske begrensningene til uforutsigbare AI-systemer?
Å integrere autonome atferdsmodeller i strukturerte narrative spill presenterer alvorlige spilldesignutfordringer når det gjelder kontroll, tempo og spillertilfredshet.
Hvis en fiendemodell lærer også effektivt oppdager den uslåelige kampløkker, pikselperfekte målrettingsrutiner og umiddelbare undertrykkelsestaktikker som frustrerer spillerne.
Spilldesignere må konstruere strenge atferdsmessige rekkverk for å begrense AI-effektiviteten, slik at motstanderne forblir utfordrende uten å bli urettferdige eller umorsomme.
Utviklere bruker nyttekurver, bevisste reaksjonsforsinkelser og sannsynligheter for feil for å holde avanserte nevrale modeller morsomme å engasjere seg i.
Å balansere dynamiske beslutningsmotorer krever grundig testing for å forhindre uventede atferdsfeil eller banebrytende kamprutiner.
Å navigere i den delikate balansen mellom autentisk digital intelligens og tilfredsstillende arkadetilbakemeldinger er fortsatt den sentrale utfordringen for moderne spillarkitekter.
Komparativ analyse: Statiske skript vs. maskinlæring med AI
Den strukturelle overgangen fra deterministiske skriptrørledninger til adaptive atferdsmodeller forandrer hvordan digitale motstandere reagerer på spillernes beslutninger.
Tabellen nedenfor beskriver de operative forskjellene mellom eldre endelige tilstandsmaskiner og moderne trente policynettverk på tvers av kjernedimensjoner i spillingen.
| Spillfunksjon | Tradisjonelle endelige tilstandsmaskiner | Maskinlæringsatferdsnettverk |
| Stifinning og navigasjon | Faste veipunktnoder, stive rutenettlinjer | Dynamisk romlig geometrivurdering, sanntids traversering |
| Kamptilpasning | Forhåndsdefinerte utløserbetingelser | Kontinuerlige oppdateringer av retningslinjene basert på taktikker fra live-spillere |
| Troppskoordinering | Delte telemetridata (veggavlesning) | Lokalisert sensorrelé, autentisk informasjonsdeling |
| Stealth Search Logic | Lineære patruljeløkker, faste siktkjegler | Probabilistiske varmekart, prediktivt romlig søk |
| Langtidshukommelse | Tilbakestill tilstand ved spillerens død/gjenoppliving | Vedvarende vektretensjon over flere spilløkter |
| Utviklingsarbeidsflyt | Manuell koding av hver beslutningsgren | Automatisert scenariotrening via forsterkningsløkker |
De levende digitale motstandernes begynnelse
Integreringen av maskinlæring inn i moderne spilldesign markerer et fundamentalt skifte bort fra forutsigbare digitale mål mot levende, pustende motstandere.
Etter hvert som nevrale treningsmodeller modnes og skyinferensrørledninger blir sømløse, vil spillverdener inneholde økosystemer som observerer, tilpasser seg og utvikler seg sammen med spillerstrategier.
Denne teknologien endrer fundamentalt hvordan spillere tilnærmer seg taktiske utfordringer, og gjør statiske kampanjer om til dynamiske kamper med intelligens og tilpasning.
Spillutviklere har makten til å bygge virtuelle verdener som utfordrer spillere uten å ty til kunstige statistikkforbedringer eller billige programmatiske wall-hacks.
Spillere vil ikke lenger beseire møter på høyt nivå ved å memorere patruljeruter eller utnytte ødelagte geometriske noder; seier vil kreve ekte taktisk fleksibilitet og kreativ problemløsning.
Etter hvert som disse adaptive systemene utvikler seg, del dine erfaringer i kommentarfeltet om hvordan smarte AI-møter har endret dine favorittspilløyeblikk.
Ofte stilte spørsmål
Vil avanserte fiendens atferdsmodeller gjøre fremtidige videospill for vanskelige for vanlige spillere?
Nei, utviklere implementerer tilpassbare vanskelighetsskaleringssystemer som justerer responsforsinkelsen, nøyaktigheten og den taktiske aggressiviteten til trente modeller.
I stedet for å utelukkende stole på rå skademultiplikatorer, endrer vanskelighetsglidebryterne hvor raskt nevrale nettverk analyserer spillerhandlinger og utfører motstrategier, noe som sikrer tilgjengelige opplevelser på tvers av alle ferdighetsnivåer.
Lammer implementering av sanntids nevral inferens systemets bildefrekvenser på moderne konsoller?
Moderne maskinvareplattformer bruker dedikerte nevrale prosesseringsblokker for å utføre lette slutningsmodeller effektivt sammen med renderingpipelines.
Ved å bruke optimaliserte nevrale nettverk behandler spillmotorer komplekse atferdsmessige beslutninger innenfor stramme mikrosekundbudsjetter, og bevarer dermed jevne bildefrekvenser under intense kampscenarier.
Hvordan hindrer spillutviklere adaptive fiender i å oppdage uslåelige kampstrategier?
Designere installerer strenge grensebetingelser, nyttebegrensninger og bevisste reaksjonsforsinkelser i belønningsfunksjonen for å begrense agentens muligheter.
Disse bevisste begrensningene hindrer modeller i å utnytte mekaniske fordeler som perfekt sikting, umiddelbare svinghastigheter eller uendelige undertrykkelsesløkker, noe som holder kampmøter engasjerende og rettferdige.
Kan adaptive fiendens atferdssystemer fungere i offline spill uten aktive internettforbindelser?
Ja, utviklere trener komplekse nevrale nettverksmodeller under spillproduksjon på høytytende skyservere, og komprimerer deretter den endelige trente policyen til en lett runtime-fil.
Lokal maskinvare leser denne forhåndstrente modellfilen offline, noe som muliggjør sofistikert adaptiv atferd uten å kreve aktive servertilkoblinger eller internettstrømming.
Hvordan skiller forsterkningslæring seg fra tradisjonelle spillprogrammeringsskript?
Tradisjonell spillprogrammering er avhengig av menneskelige utviklere som manuelt skriver alle betingelsessetninger, regler og beslutningstre for en fiendtlig agent.
Forsterkningslæring gir en agent mål, miljømessige begrensninger og et belønningssystem, slik at systemet kan oppdage optimale taktiske manøvrer gjennom millioner av selvspill-iterasjoner.
