
Hoe machine learning het gedrag van vijanden in toekomstige games zou kunnen veranderen
Anúncios
Machine learning Dit verandert de manier waarop niet-speelbare personages moderne gamestrategieën observeren, zich eraan aanpassen en erop reageren in complexe digitale omgevingen.
Spelers hebben decennialang geprofiteerd van statische gedragsbomen, voorspelbare padvindingsroutines en telepathische bewakers-AI die gereset wordt zodra een timer afloopt.
Moderne game-engines laten eindelijk de rigide scriptbeperkingen achter zich en bouwen responsieve ecosystemen die direct leren van de beslissingen van de speler.
Traditioneel vijandontwerp is sterk gebaseerd op vastgelegde toestandsautomaten, waarbij ontwikkelaars elke beslissingstak, limiet en voorwaarde handmatig programmeren.
Wanneer spelers een maas in die statische scripts ontdekken, verdwijnt de illusie van uitdaging als sneeuw voor de zon, waardoor het spel triviaal aanvoelt.
Anúncios
Dynamische algoritmen stellen ontwikkelaars in staat om neurale netwerken te trainen op miljoenen interacties tussen spelers, waardoor tegenstanders ontstaan die hun tactieken in realtime aanpassen.
Wat u in dit artikel zult ontdekken
- Wat is machine learning in game-ontwerp?
- Hoe vervangen neurale netwerken statische scripts?
- Waarom werken traditionele vijandscripts niet voor moderne spelers?
- Hoe traint reinforcement learning virtuele tegenstanders?
- Hoe hervormt dynamisch gedrag dynamische gevechtssystemen?
- Waarom vervangen adaptieve flankeringstactieken vaste patrouilles?
- Hoe kunnen NPC-teams hun tactieken coördineren zonder vals te spelen?
- Welke rol speelt voorspellende routeplanning in stealthgames?
- Wat staat de volgende generatie vijandelijke inlichtingendiensten te wachten?
- Waarom is procedureel geheugen essentieel voor Persistent Rivals?
- Hoe zal cloudcomputing realtime gedragsmodellen verwerken?
- Wat zijn de architectonische beperkingen van onvoorspelbare AI-systemen?
- Vergelijkende analyse: statische scripts versus machine learning AI
- Het aanbreken van de digitale revolutie
- Veelgestelde vragen
Wat is machine learning in game-ontwerp?
Hoe vervangen neurale netwerken statische scripts?
Geavanceerd machinaal leren Frameworks vervangen voorwaardelijke "als-dan"-lussen door flexibele beleidsnetwerken die de actuele spelstatus continu evalueren.
In plaats van zich te houden aan strikte regels code die door ontwerpers zijn geschreven, evalueren deze systemen tegelijkertijd afstand, zichtlijn, gezondheidsreserves en wapenkeuzes om optimale tegenstrategieën te selecteren.
Deze fundamentele verschuiving transformeert statische digitale doelen in flexibele tegenstanders die gevechtspatronen analyseren en hun positionering dynamisch aanpassen tijdens actieve confrontaties.
Voor de implementatie is het nodig om modellen te trainen op enorme datasets van spelersbewegingen, resourcebeheer en tactische positionering om basisparameters voor gedrag vast te stellen.
Ontwikkelaars voeren gesimuleerde gevechtsscenario's in deep learning-pipelines, waardoor het systeem zijn reacties kan verfijnen aan de hand van miljoenen iteratieve gevechten voordat het wordt uitgebracht.
De uiteindelijke runtime-agent maakt gebruik van lichtgewicht inferentiemodellen om de input van de speler direct te verwerken, waardoor een vloeiende framerate behouden blijft en er intelligente, contextbewuste beslissingen worden genomen.
Waarom werken traditionele vijandscripts niet voor moderne spelers?
Traditionele vijandelijke scenario's zijn gebaseerd op deterministische eindige-toestandsmachines die bezwijken onder het gewicht van creatieve, onvoorspelbare spelersstrategieën.
Ervaren gamers onthouden snel patrouilleroutes, zichtlijnen en aanvalsintervallen, waardoor spannende gevechten worden gereduceerd tot repetitieve ruimtelijke puzzels.
Zodra een speler een onverwachte blinde vlek of een zwak punt in de padvindingsgeometrie ontdekt, verdwijnt de kunstmatige uitdaging volledig.
Ook bij voorgeprogrammeerde vijanden is er sprake van een kunstmatige tweedeling tussen alwetende tracking en volledige blindheid, waarbij ze vaak ogenblikkelijk tussen beide toestanden wisselen.
Ze beschikken ofwel over bovennatuurlijke kennis van de exacte coördinaten van de speler door middel van het aflezen van de muurgeometrie, ofwel staan ze onbewust toe te kijken hoe bondgenoten in de buurt neervallen.
Dit binaire operationele model doorbreekt de immersie van de speler en benadrukt de mechanische beperkingen van traditionele game-architectuur.
++ De toekomst van games met gedeelde werelden, voorbij de MMO-formule.
Hoe traint reinforcement learning virtuele tegenstanders?
Reinforcement learning-modellen gebruiken beloningsfuncties om virtuele tegenstanders te stimuleren tot strategische doelen zoals ruimtelijke controle, flankaanvallen en overleving.
Digitale agenten ontvangen positieve wiskundige feedback wanneer ze erin slagen ontsnappingsroutes van spelers af te snijden of de gezondheid van hun team te behouden tijdens vuurgevechten.
Door miljoenen keren zelfstandig te spelen in gesimuleerde omgevingen, ontdekken agenten op natuurlijke wijze geavanceerde tactische manoeuvres zonder expliciete instructies van de ontwikkelaar.
Sony AI demonstreerde dit transformatieve potentieel door Sony AI's Gran Turismo Sophy te ontwikkelen, een agent die getraind is via deep reinforcement learning en die complexe voertuigdynamiek, racelijnen en defensieve positionering beheerste om top esports-kampioenen te verslaan.
In plaats van vastgelegde rijroutes te ontvangen, leerde Sophy de optimale rempunten en tactische inhaalmanoeuvres door voortdurend te experimenteren.
Door vergelijkbare trainingsarchitecturen toe te passen op actiegames kunnen vijanden complexe gevechtsmechanismen met menselijke precisie leren.
Hoe hervormt dynamisch gedrag dynamische gevechtssystemen?
Waarom vervangen adaptieve flankeringstactieken vaste patrouilles?
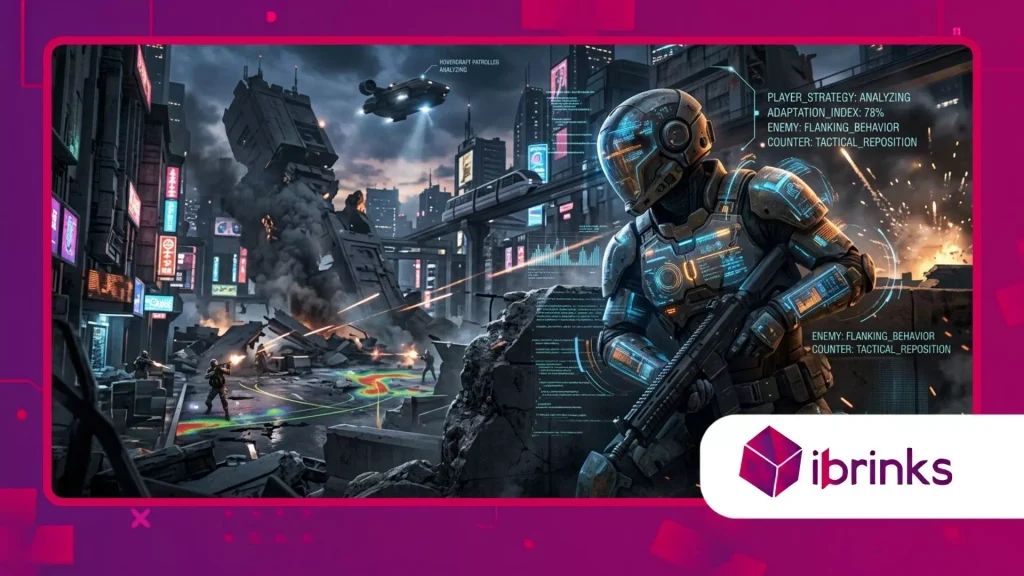
Moderne gevechten vereisen adaptieve tegenstanders die hun ruimtelijke bewegingen aanpassen aan de positie van de speler, de beschikbaarheid van dekking en de mate van wapenonderdrukking.
In plaats van langs vooraf bepaalde dekkingspunten te rennen, evalueren vijanden, aangedreven door dynamische modellen, de terreingeometrie in realtime om gunstige schietposities te vinden.
Deze structurele evolutie dwingt spelers om statische kampeerstrategieën op te geven, aangezien digitale tegenstanders actief rond dekking manoeuvreren om verdedigingsposities te doorbreken.
Adaptieve agenten analyseren wapenbereik, herlaadcycli en zichtlijn om op meerdere fronten druk uit te oefenen zonder tussenkomst van een ontwerper.
Wanneer een speler zijn vuur in één richting concentreert, identificeren flankerende eenheden de blinde vlek en rukken op via de ondoorzichtige vuurlijnen.
Deze vloeiende beweging creëert organische gevechtsscenario's waarbij de frontlinies dynamisch verschuiven op basis van de prestaties van de speler in plaats van door vooraf ingestelde triggers.
Lees ook: De opkomst van door de gemeenschap gedreven routekaarten die vaste ontwikkelingsplannen vervangen.
Hoe kunnen NPC-teams hun tactieken coördineren zonder vals te spelen?
In klassieke games werd groepsintelligentie vaak gesimuleerd door teamleden gedeelde telemetriegegevens te geven, waardoor ze spelers door vaste oppervlakken heen konden volgen.
Modern machinaal leren De modellen maken authentieke coördinatie van teams mogelijk door middel van gelokaliseerde communicatieprotocollen, waarmee ze tactische eenheden uit de praktijk nabootsen die zichtlijngegevens delen vanuit hun eigen perspectief.
Vijanden reageren uitsluitend op informatie die is geverifieerd door hun eigen visuele of akoestische sensoren, waardoor ze eerlijk spel behouden en tegelijkertijd een geavanceerde teamstrategie demonstreren.
Gecoördineerde pelotonsmodellen verdelen tactische rollen dynamisch, waarbij dekkingsvuur, terugtrekkingsdekking en flankeringsmanoeuvres worden toegewezen op basis van de gezondheid en bewapening van de eenheid.
Als een zware eenheid met een schild oprukt, nemen ondersteunende geweerschutters automatisch dekking achter het oprukkende pantser om de positie van de speler onder druk te zetten.
Deze spontaan ontstane coördinatie voelt authentiek aan, omdat elke eenheid handelt op basis van geloofwaardige veldgegevens in plaats van goedkope, programmatische trucjes.
Welke rol speelt voorspellende routeplanning in stealthgames?
De gameplay van stealth-games verandert drastisch wanneer zoekalgoritmes lineaire patrouillelussen vervangen door probabilistische hittekaarten die zijn afgeleid van spelersgewoonten.
In plaats van vaste routes te volgen, analyseren voorspellende zoekmodellen zichtlijnbreuken, open deuren en geluidssporen om te schatten waar stealth-spelers zich schuilhouden.
Vijanden concentreren hun onderzoek op waarschijnlijke schuilplaatsen, waardoor routinematige zoekfasen veranderen in spannende tactische ontwijkingen.
Voorspellende padvindingsalgoritmen berekenen potentiële bewegingsvectoren op basis van hoe lang een speler geen direct visueel contact meer heeft gehad.
Als er een alarm afgaat aan de perimeter, berekenen de bewakers de maximale afstand die een speler binnen dat tijdsbestek zou kunnen afleggen en vormen ze dienovereenkomstig zoekzones.
Heb je je ooit afgevraagd hoe angstaanjagend heimelijke confrontaties kunnen worden wanneer bewakers actief je ontsnappingsroute proberen te voorspellen in plaats van je spoor te volgen?
Wat staat de volgende generatie vijandelijke inlichtingendiensten te wachten?
Waarom is procedureel geheugen essentieel voor Persistent Rivals?
Aanhoudende rivaliteitssystemen maken gebruik van langetermijngeheugenarchitecturen om gegevens over speelstijlen, favoriete wapens en gevechtsneigingen van spelers gedurende langdurige campagnes te bewaren.
Wanneer een vijand een confrontatie overleeft, past het onderliggende model de beslissingsgewichten aan om de specifieke tactieken te counteren die hem eerder verslagen hebben.
Als een speler veel gebruikmaakt van langeafstandssluipschuttersgeweren, verschijnen terugkerende tegenstanders met rookgranaten, zware bepantsering en tactieken voor gevechten van dichtbij.
Procedureel geheugen transformeert terugkerende vijandelijke confrontaties van repetitieve statistiekcontroles in evoluerende persoonlijke rivaliteiten die de geschiedenis van de speler weerspiegelen.
Tegenstanders herinneren zich fysieke littekens, tactische nederlagen en hachelijke ontsnappingen, en passen hun verbale reacties en gevechtsgedrag aan tijdens latere confrontaties.
Deze historische continuïteit versterkt de betrokkenheid van spelers op de lange termijn, omdat elke tactische overwinning de bredere dreigingsomgeving verandert.
Hoe zal cloudcomputing realtime gedragsmodellen verwerken?
Het uitvoeren van complexe neurale netwerkinferentiemodellen in combinatie met hoogwaardige grafische rendering leidt tot ernstige prestatieknelpunten voor de lokale consolehardware.
Cloud-ondersteunde architectuur lost deze rekenbeperking op door intensieve gedragsmodellen op externe servers uit te voeren en geoptimaliseerde tactische beslissingen terug te streamen naar de gameclient.
Dit ontlast de lokale processoren van zware lineaire algebra-berekeningen, waardoor ontwikkelaars enorme, zeer intelligente vijandelijke facties kunnen inzetten zonder dat dit ten koste gaat van de framerate.
Gedistribueerde cloudcomputingnetwerken maken het mogelijk dat duizenden actieve game-instanties continu geanonimiseerde gegevens over spelersbeslissingen terugkoppelen naar een gecentraliseerd model.
Terwijl miljoenen spelers wereldwijd nieuwe exploits testen, werkt het gecentraliseerde netwerk de tegenstrategieën van de vijand in realtime bij voor de gehele spelersbasis.
Deze continue dataloop zorgt ervoor dat vijandelijke inlichtingen zich ontwikkelen in lijn met de wereldwijde strategieën van de gemeenschap, waardoor stagnatie in de metagame wordt voorkomen.
Wat zijn de architectonische beperkingen van onvoorspelbare AI-systemen?
Het integreren van autonome gedragsmodellen in gestructureerde, verhalende games brengt serieuze uitdagingen met zich mee op het gebied van game-ontwerp, met name wat betreft besturing, tempo en spelerssatisfactie.
Als een vijandelijk model leert te Het programma ontdekt op efficiënte wijze onverslaanbare gevechtspatronen, pixelprecieze richtroutines en tactieken om vijanden direct uit te schakelen, wat spelers tot wanhoop drijft.
Spelontwerpers moeten strikte gedragsregels opstellen om de effectiviteit van AI te beperken, zodat tegenstanders uitdagend blijven zonder oneerlijk of saai te worden.
Ontwikkelaars gebruiken nuttigheidscurven, opzettelijke reactievertragingen en faalkansen om geavanceerde neurale modellen leuk te houden om mee te werken.
Het balanceren van dynamische beslissingssystemen vereist grondige tests om onverwachte gedragsfouten of spelverstorende gevechtsroutines te voorkomen.
Het vinden van de juiste balans tussen authentieke digitale intelligentie en bevredigende arcade-ervaring blijft de grootste uitdaging voor moderne game-ontwikkelaars.
Vergelijkende analyse: statische scripts versus machine learning AI
De structurele overgang van deterministische scriptpipelines naar adaptieve gedragsmodellen verandert de manier waarop digitale tegenstanders reageren op beslissingen van spelers.
De onderstaande tabel geeft een overzicht van de operationele verschillen tussen traditionele eindige-toestandsmachines en moderne, getrainde beleidsnetwerken, gemeten aan de hand van de belangrijkste spelaspecten.
| Gameplay-functie | Traditionele eindige toestandsmachines | Machine learning gedragsnetwerken |
| Routeplanning en navigatie | Vaste waypoint-knooppunten, starre rasterlijnen | Dynamische ruimtelijke geometrie-evaluatie, realtime doorloop |
| Gevechtsaanpassing | Voorgeprogrammeerde triggercondities | Continue beleidsupdates op basis van live spelers tactieken |
| Teamcoördinatie | Gedeelde telemetriegegevens (muurmeting) | Lokale sensorrelais, authentieke informatie-uitwisseling |
| Logica voor verborgen zoeken | Lineaire patrouillelussen, vaste zichtkegels | Probabilistische hittekaarten, voorspellende ruimtelijke zoekopdrachten |
| Langetermijngeheugen | De status wordt gereset bij het overlijden/respawnen van de speler. | Aanhoudend gewichtsbehoud gedurende meerdere speelsessies. |
| Ontwikkelingsworkflow | Handmatige codering van elke beslissingstak | Geautomatiseerde scenariotraining via versterkingslussen |
Het aanbreken van de digitale revolutie
De integratie van machinaal leren De moderne game-ontwikkeling markeert een fundamentele verschuiving weg van voorspelbare digitale doelen naar levende, ademende tegenstanders.
Naarmate neurale trainingsmodellen zich verder ontwikkelen en inferentieprocessen in de cloud naadloos verlopen, zullen spelwerelden ecosystemen bevatten die observeren, zich aanpassen en evolueren parallel aan de strategieën van de speler.
Deze technologie verandert fundamenteel de manier waarop spelers tactische uitdagingen benaderen, waardoor statische campagnes veranderen in dynamische gevechten van intelligentie en aanpassingsvermogen.
Spelontwikkelaars hebben de macht om virtuele werelden te creëren die spelers uitdagen zonder hun toevlucht te nemen tot kunstmatige statistiekverhogingen of goedkope programmeertrucs.
Spelers zullen gevechten op hoog niveau niet langer winnen door patrouilleroutes uit het hoofd te leren of gebruik te maken van defecte geometrische knooppunten; de overwinning vereist echte tactische flexibiliteit en creatief probleemoplossend vermogen.
Naarmate deze adaptieve systemen zich verder ontwikkelen, deel dan in de reacties je ervaringen over hoe slimme AI-interacties je favoriete game-momenten hebben veranderd.
Veelgestelde vragen
Zullen geavanceerde modellen voor vijandelijk gedrag toekomstige videogames te moeilijk maken voor casual spelers?
Nee, ontwikkelaars implementeren aanpasbare systemen voor het schalen van de moeilijkheidsgraad, waarmee de reactietijd, nauwkeurigheid en tactische agressiviteit van getrainde modellen worden aangepast.
In plaats van uitsluitend te vertrouwen op pure schademultiplicatoren, passen moeilijkheidsgraden aan hoe snel neurale netwerken de acties van de speler analyseren en tegenstrategieën uitvoeren, waardoor een toegankelijke spelervaring voor alle vaardigheidsniveaus wordt gegarandeerd.
Zorgt de implementatie van realtime neurale inferentie voor een aanzienlijke daling van de framesnelheid op moderne consoles?
Moderne hardwareplatforms maken gebruik van speciale neurale verwerkingsblokken om lichtgewicht inferentiemodellen efficiënt uit te voeren naast renderingpipelines.
Door gebruik te maken van geoptimaliseerde neurale netwerken verwerken game-engines complexe gedragsbeslissingen binnen een tijdsbestek van microseconden, waardoor een vloeiende framerate behouden blijft tijdens intense gevechtsscenario's.
Hoe voorkomen gameontwikkelaars dat adaptieve vijanden onverslaanbare gevechtsstrategieën ontdekken?
Ontwerpers implementeren strikte randvoorwaarden, gebruiksbeperkingen en opzettelijke reactievertragingen in de beloningsfunctie om de mogelijkheden van de agent te beperken.
Deze weloverwogen beperkingen voorkomen dat modellen mechanische voordelen zoals perfect richten, razendsnelle draaisnelheden of oneindige onderdrukkingsloops uitbuiten, waardoor gevechten boeiend en eerlijk blijven.
Kunnen adaptieve vijandelijke gedragssystemen functioneren in offline games zonder actieve internetverbinding?
Ja, ontwikkelaars trainen complexe neurale netwerkmodellen tijdens de gameproductie op krachtige cloudservers en comprimeren vervolgens het uiteindelijke getrainde beleid tot een lichtgewicht runtimebestand.
De lokale hardware leest dit vooraf getrainde modelbestand offline, waardoor geavanceerd adaptief gedrag mogelijk is zonder actieve serververbindingen of internetstreaming.
Hoe verschilt reinforcement learning van traditionele gameprogrammeermethoden?
Traditionele gameprogrammering is gebaseerd op het handmatig schrijven van elke voorwaardelijke instructie, regel en beslissingsboom voor een vijandelijke agent door menselijke ontwikkelaars.
Reinforcement learning voorziet een agent van doelen, omgevingsbeperkingen en een beloningssysteem, waardoor het systeem door middel van miljoenen zelfoefeningen optimale tactische manoeuvres kan ontdekken.
