
Bagaimana Pembelajaran Mesin Boleh Mengubah Tingkah Laku Musuh dalam Permainan Masa Depan
Annúncios
Pembelajaran mesin sedang mengubah cara watak bukan pemain memerhati, menyesuaikan diri dan bertindak balas terhadap strategi permainan moden merentasi persekitaran digital yang kompleks.
Pemain telah menghabiskan beberapa dekad mengeksploitasi pokok tingkah laku statik, rutin pencarian laluan yang boleh diramal dan AI pengawal telepati yang menetapkan semula sebaik sahaja pemasa tamat tempoh.
Enjin permainan moden akhirnya beralih daripada kekangan skrip yang tegar untuk membina ekosistem responsif yang belajar secara langsung daripada keputusan pemain.
Reka bentuk musuh tradisional sangat bergantung pada mesin keadaan berkod keras di mana pembangun memprogram setiap cabang, had dan syarat keputusan secara manual.
Apabila pemain menemui kelemahan dalam skrip statik tersebut, ilusi cabaran serta-merta berkecai, menjadikan permainan terasa remeh.
Annúncios
Algoritma dinamik membolehkan pembangun melatih rangkaian saraf pada berjuta-juta interaksi pemain, mewujudkan lawan yang menyesuaikan taktik mereka dalam masa nyata.
Apa yang Akan Anda Terokai dalam Artikel Ini
- Apakah Pembelajaran Mesin dalam Reka Bentuk Permainan?
- Bagaimanakah Rangkaian Neural Menggantikan Skrip Statik?
- Mengapa Skrip Musuh Tradisional Menggagalkan Pemain Moden?
- Bagaimanakah Pembelajaran Pengukuhan Melatih Lawan Maya?
- Bagaimanakah Tingkah Laku Dinamik Membentuk Semula Sistem Pertempuran Dinamik?
- Mengapa Taktik Mengapit Adaptif Menggantikan Rondaan Tetap?
- Bagaimanakah Skuad NPC Boleh Menyelaras Taktik Tanpa Menipu?
- Apakah Peranan Pencari Laluan Ramalan dalam Permainan Stealth?
- Apakah yang Akan Datang untuk Perisikan Musuh Generasi Akan Datang?
- Mengapakah Memori Prosedural Penting untuk Pesaing yang Berterusan?
- Bagaimanakah Pengkomputeran Awan Akan Memproses Model Tingkah Laku Masa Nyata?
- Apakah Had Senibina Sistem AI yang Tidak Dapat Diramalkan?
- Analisis Perbandingan: Skrip Statik vs. AI Pembelajaran Mesin
- Awal Kehidupan Musuh Digital
- Soalan Lazim
Apakah Pembelajaran Mesin dalam Reka Bentuk Permainan?
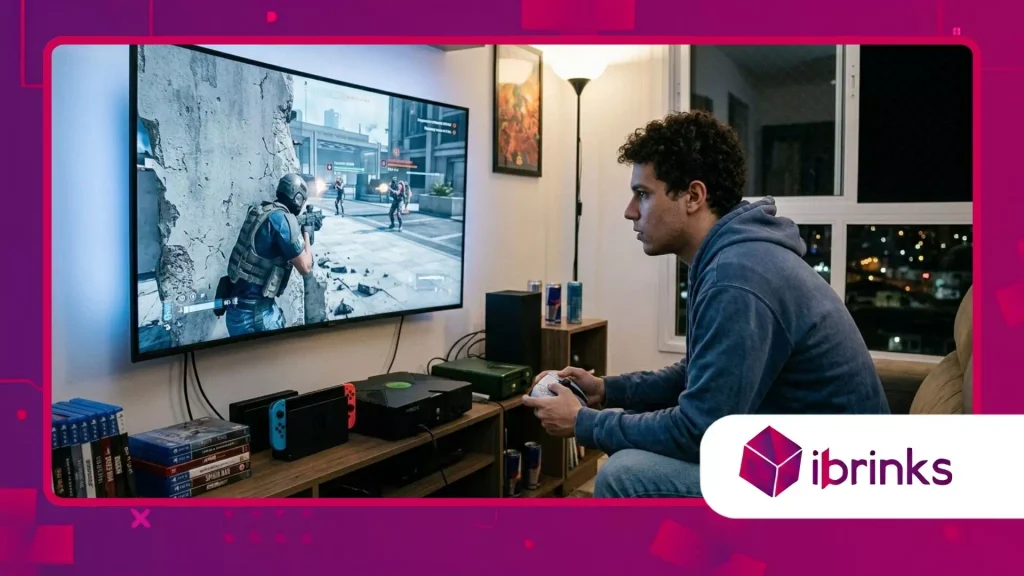
Bagaimanakah Rangkaian Neural Menggantikan Skrip Statik?
Lanjutan pembelajaran mesin Rangka kerja menggantikan gelung "jika-maka" bersyarat dengan rangkaian dasar fleksibel yang menilai vektor keadaan permainan langsung secara berterusan.
Daripada mengikuti baris kod tegar yang ditulis oleh pereka, sistem ini menilai jarak, garis penglihatan, rizab kesihatan dan pilihan senjata secara serentak untuk memilih strategi balas yang optimum.
Peralihan asas ini menukarkan sasaran digital statik kepada lawan yang fleksibel yang menganalisis corak pertempuran dan melaraskan kedudukan mereka secara dinamik semasa pertempuran aktif.
Pelaksanaan memerlukan model latihan pada set data pergerakan pemain, pengurusan sumber dan kedudukan taktikal yang luas untuk menetapkan parameter tingkah laku asas.
Pembangun memasukkan senario pertempuran simulasi ke dalam saluran pembelajaran mendalam, membolehkan sistem memperhalusi responsnya merentasi berjuta-juta pertempuran berulang sebelum dikeluarkan.
Ejen runtime akhir menggunakan model inferens ringan untuk memproses input pemain serta-merta, mengekalkan kadar bingkai yang lancar sambil membuat keputusan pintar dan peka konteks.
Mengapa Skrip Musuh Tradisional Menggagalkan Pemain Moden?
Skrip musuh konvensional bergantung pada mesin keadaan terhingga deterministik yang runtuh di bawah beban strategi pemain yang kreatif dan tidak dapat diramalkan.
Pemain berpengalaman dengan cepat menghafal laluan rondaan, kon penglihatan dan selang serangan, sekali gus mengurangkan pertempuran berisiko tinggi kepada teka-teki ruang yang berulang-ulang.
Sebaik sahaja pemain menemui titik buta yang tidak diskripkan atau eksploitasi dalam geometri pencari laluan, cabaran buatan itu akan hilang sepenuhnya.
Musuh yang diskripkan juga mengalami jurang buatan antara pengesanan maha mengetahui dan kebutaan sepenuhnya, selalunya bertukar antara kedua-dua keadaan dengan serta-merta.
Mereka sama ada memiliki pengetahuan ghaib tentang koordinat tepat pemain melalui bacaan geometri dinding atau berdiri tanpa menyedarinya sementara sekutu jatuh berdekatan.
Model operasi binari ini memecahkan rendaman pemain, menonjolkan batasan mekanikal seni bina permainan tradisional.
++ Masa depan permainan dunia kongsi melangkaui formula MMO
Bagaimanakah Pembelajaran Pengukuhan Melatih Lawan Maya?
Model pembelajaran pengukuhan menggunakan fungsi ganjaran untuk memberi insentif kepada lawan maya ke arah objektif strategik seperti kawalan ruang, pelaksanaan sayap dan kelangsungan hidup.
Ejen digital menerima maklum balas matematik yang positif apabila berjaya memotong laluan melarikan diri pemain atau memelihara kesihatan skuad semasa pertempuran.
Melalui berjuta-juta lelaran main sendiri dalam persekitaran simulasi, ejen secara semula jadi menemui manuver taktikal yang canggih tanpa arahan pembangun yang eksplisit.
Sony AI menunjukkan potensi transformatif ini dengan membangunkan Gran Turismo Sophy Sony AI, sebuah ejen yang dilatih melalui pembelajaran peneguhan mendalam yang menguasai dinamik kenderaan yang kompleks, garis perlumbaan dan kedudukan pertahanan untuk mengalahkan juara e-sukan manusia terkemuka.
Daripada menerima laluan pemanduan yang dikodkan secara tetap, Sophy mempelajari titik brek optimum dan pemotongan taktikal melalui percubaan dan kesilapan yang berterusan.
Menggunakan seni bina latihan yang serupa dengan permainan aksi membolehkan musuh mempelajari mekanik tempur kompleks dengan ketepatan seperti manusia.
Bagaimanakah Tingkah Laku Dinamik Membentuk Semula Sistem Pertempuran Dinamik?
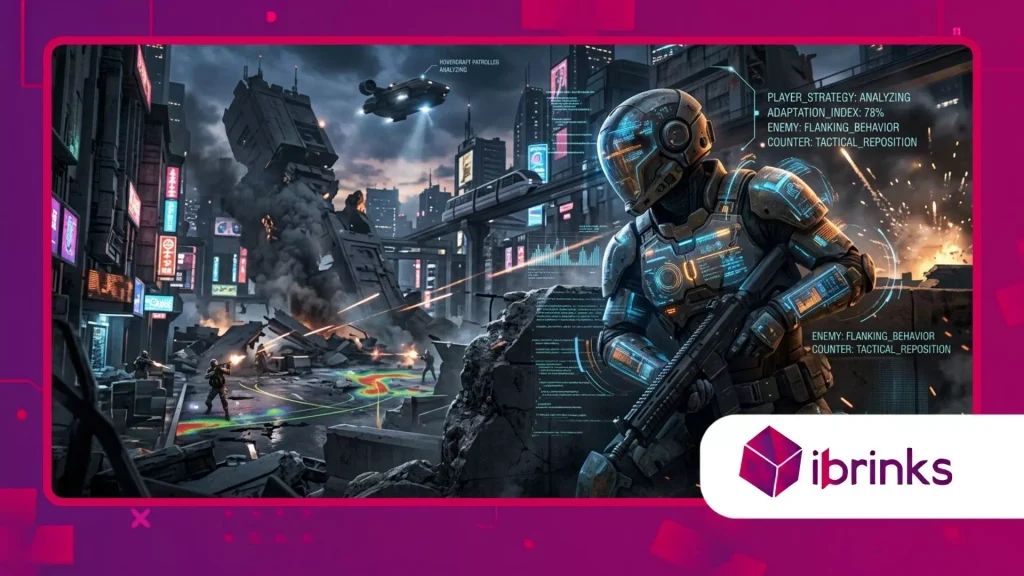
Mengapa Taktik Mengapit Adaptif Menggantikan Rondaan Tetap?
Pertempuran moden memerlukan musuh adaptif yang melaraskan pergerakan ruang mereka berdasarkan kedudukan pemain, ketersediaan perlindungan dan penindasan senjata.
Daripada berlari di sepanjang nod penutup yang telah dibakar, musuh yang dikuasakan oleh model dinamik menilai geometri rupa bumi dalam masa nyata untuk mencari sudut tembakan yang berfaedah.
Evolusi struktur ini memaksa pemain untuk meninggalkan strategi perkhemahan statik, kerana lawan digital secara aktif bergerak di sekitar perlindungan untuk menembusi posisi pertahanan.
Ejen adaptif menganalisis jarak senjata, kitaran muat semula dan pendedahan garis pandangan untuk melaksanakan taktik tekanan berbilang serampang tanpa campur tangan pereka.
Apabila pemain memfokuskan tembakan ke satu arah, unit mengapit mengenal pasti titik buta visual dan mara di sepanjang saluran yang dihalang.
Pergerakan yang lancar ini mewujudkan senario pertempuran organik di mana barisan pertempuran beralih secara dinamik berdasarkan prestasi pemain dan bukannya pencetus skrip.
Baca juga: Kebangkitan pelan hala tuju yang dipacu komuniti menggantikan pelan pembangunan tetap
Bagaimanakah Skuad NPC Boleh Menyelaras Taktik Tanpa Menipu?
Permainan legasi kerap mensimulasikan kecerdasan kumpulan dengan memberikan data telemetri yang dikongsi kepada ahli skuad, membolehkan mereka menjejaki pemain melalui permukaan pepejal.
Moden pembelajaran mesin Model membolehkan penyelarasan skuad yang autentik melalui protokol komunikasi setempat, meniru unit taktikal dunia sebenar yang berkongsi data pandangan langsung mengikut perspektif mereka.
Musuh bertindak balas semata-mata terhadap maklumat yang disahkan oleh sensor visual atau akustik mereka sendiri, mengekalkan permainan yang adil sambil menunjukkan strategi pasukan yang canggih.
Model skuad yang diselaraskan mengagihkan peranan taktikal secara dinamik, memberikan tembakan penindasan, liputan berundur dan manuver mengapit berdasarkan kesihatan dan persenjataan unit.
Jika unit berat mara dengan perisai, anggota senapang sokongan akan berlindung secara automatik di sebalik perisai yang mara untuk menekan kedudukan pemain.
Koordinasi yang muncul ini terasa asli kerana setiap unit bertindak berdasarkan data lapangan yang boleh dipercayai dan bukannya penipuan programatik yang murahan.
Baca lebih lanjut: Bagaimana permainan moden mengimbangi kebebasan vs bimbingan tanpa pegangan tangan
Apakah Peranan Pencari Laluan Ramalan dalam Permainan Stealth?
Permainan sembunyi-sembunyi berubah secara mendadak apabila algoritma carian menggantikan gelung rondaan linear dengan peta haba probabilistik yang diperoleh daripada tabiat pemain.
Daripada berjalan di laluan tetap, model carian ramalan menilai pelanggaran garis pandangan, pintu terbuka dan jejak bunyi untuk menganggarkan di mana pemain siluman bersembunyi.
Musuh menumpukan usaha siasatan mereka di tempat persembunyian yang berkemungkinan tinggi, mengubah fasa pencarian rutin menjadi pengelakan taktikal yang tegang.
Algoritma pencari laluan ramalan mengira vektor pergerakan berpotensi berdasarkan berapa lama pemain telah berada di luar hubungan visual secara langsung.
Jika penggera berbunyi di perimeter, pengawal mengira jarak maksimum yang boleh dilalui oleh pemain dalam tempoh masa tersebut dan membentuk perimeter penggeledahan dengan sewajarnya.
Pernahkah anda tertanya-tanya betapa menakutkannya pertemuan rahsia apabila pengawal secara aktif menjangka laluan melarikan diri anda dan bukannya mengikuti denai yang tidak jelas?
Apakah yang Akan Datang untuk Perisikan Musuh Generasi Akan Datang?
Mengapakah Memori Prosedural Penting untuk Pesaing yang Berterusan?
Sistem saingan berterusan menggunakan seni bina memori jangka panjang untuk menyimpan rekod gaya permainan pemain, senjata kegemaran dan kecenderungan pertempuran merentasi kempen lanjutan.
Apabila musuh terselamat dalam pertempuran, model asasnya mengemas kini pemberat keputusannya untuk mengatasi taktik khusus yang mengalahkannya sebelum ini.
Jika pemain banyak bergantung pada senapang penembak tepat jarak jauh, pesaing yang kembali akan muncul dengan bom asap, perisai berat dan taktik serangan jarak dekat.
Ingatan prosedural mengubah pertemuan musuh yang berulang daripada pemeriksaan statistik berulang kepada persaingan peribadi yang berkembang yang mencerminkan sejarah pemain.
Musuh mengingati parut fizikal, kekalahan taktikal, dan peluang untuk terlepas daripada pertempuran, mengubah tindak balas lisan dan tingkah laku pertempuran mereka semasa pertarungan berikutnya.
Kesinambungan sejarah ini memperdalam penglibatan pemain jangka panjang, kerana setiap kemenangan taktikal membentuk semula persekitaran ancaman yang lebih luas.
Bagaimanakah Pengkomputeran Awan Akan Memproses Model Tingkah Laku Masa Nyata?
Melaksanakan model inferens rangkaian neural yang kompleks di samping pemaparan grafik mewah memberikan kesesakan prestasi yang teruk untuk perkakasan konsol tempatan.
Seni bina berbantukan awan menyelesaikan kekangan pengiraan ini dengan menjalankan model tingkah laku intensif pada pelayan jauh dan menstrim keputusan taktikal yang dioptimumkan kembali kepada klien permainan.
Ini mengurangkan pengiraan algebra linear yang berat daripada pemproses tempatan, membolehkan pembangun menggunakan puak musuh yang besar dan sangat pintar tanpa menjejaskan kadar bingkai.
Rangkaian pengiraan awan teragih membolehkan beribu-ribu contoh permainan aktif memasukkan data keputusan pemain tanpa nama kembali ke dalam model berpusat secara berterusan.
Ketika berjuta-juta pemain menguji eksploitasi baharu di seluruh dunia, rangkaian berpusat mengemas kini strategi balas musuh dalam masa nyata merentasi seluruh pangkalan pemain.
Gelung data berterusan ini memastikan bahawa risikan musuh berkembang seiring dengan strategi komuniti global, mencegah genangan meta-permainan.
Apakah Had Senibina Sistem AI yang Tidak Dapat Diramalkan?
Mengintegrasikan model tingkah laku autonomi ke dalam permainan naratif berstruktur memberikan cabaran reka bentuk permainan yang serius mengenai kawalan, rentak dan kepuasan pemain.
Jika model musuh belajar juga dengan cekap, ia menemui gelung pertempuran yang tiada tandingan, rutin penargetan piksel yang sempurna dan taktik penindasan segera yang membuatkan pemain kecewa.
Pereka permainan mesti membina pagar kawalan tingkah laku yang ketat untuk mengehadkan kecekapan AI, memastikan lawan kekal mencabar tanpa menjadi tidak adil atau tidak menyeronokkan.
Pembangun menggunakan lengkung utiliti, kelewatan tindak balas yang disengajakan dan kebarangkalian kegagalan untuk memastikan model saraf lanjutan menyeronokkan untuk digunakan.
Mengimbangi enjin keputusan dinamik memerlukan ujian yang ketat untuk mencegah pepijat tingkah laku yang tidak dijangka atau rutin pertempuran yang memecah permainan.
Menavigasi keseimbangan halus antara kecerdasan digital yang tulen dan maklum balas arked yang memuaskan kekal sebagai cabaran utama bagi arkitek permainan moden.
Analisis Perbandingan: Skrip Statik vs. AI Pembelajaran Mesin
Peralihan struktur daripada saluran paip skrip deterministik kepada model tingkah laku adaptif mengubah cara musuh digital bertindak balas terhadap keputusan pemain.
Jadual di bawah memperincikan perbezaan operasi antara mesin keadaan terhingga legasi dan rangkaian dasar terlatih moden merentasi dimensi permainan teras.
| Ciri Permainan | Mesin Keadaan Terhingga Tradisional | Rangkaian Tingkah Laku Pembelajaran Mesin |
| Pencarian Laluan & Navigasi | Nod titik laluan tetap, garisan grid tegar | Penilaian geometri ruang dinamik, traslasi masa nyata |
| Adaptasi Pertempuran | Syarat pencetus pra-skrip | Kemas kini dasar berterusan berdasarkan taktik pemain langsung |
| Penyelarasan Skuad | Data telemetri kongsi (bacaan dinding) | Geganti sensor setempat, perkongsian maklumat yang sahih |
| Logik Carian Senyap | Gelung rondaan linear, kon penglihatan tetap | Peta haba probabilistik, carian ruang ramalan |
| Ingatan Jangka Panjang | Tetapkan semula keadaan apabila pemain mati/muncul semula | Pengekalan berat badan berterusan merentasi pelbagai sesi permainan |
| Aliran Kerja Pembangunan | Pengekodan manual setiap cabang keputusan | Latihan senario automatik melalui gelung pengukuhan |
Awal Kehidupan Musuh Digital
Integrasi pembelajaran mesin ke dalam reka bentuk permainan moden menandakan peralihan asas daripada sasaran digital yang boleh diramal kepada lawan yang hidup dan bernafas.
Apabila model latihan saraf matang dan saluran paip inferens awan menjadi lancar, dunia permainan akan menampilkan ekosistem yang memerhati, menyesuaikan diri dan berkembang bersama strategi pemain.
Teknologi ini secara asasnya mengubah cara pemain menghadapi cabaran taktikal, mengubah kempen statik menjadi pertempuran dinamik kecerdasan dan penyesuaian.
Pembangun permainan memegang kuasa untuk membina dunia maya yang mencabar pemain tanpa menggunakan peningkatan statistik buatan atau penggodaman dinding programatik yang murah.
Pemain tidak lagi akan mengalahkan pertempuran peringkat tinggi dengan menghafal laluan rondaan atau mengeksploitasi nod geometri yang rosak; kemenangan memerlukan fleksibiliti taktikal yang tulen dan penyelesaian masalah yang kreatif.
Seiring perkembangan sistem adaptif ini, kongsikan pengalaman anda dalam ruangan komen tentang bagaimana pertemuan AI pintar telah mengubah detik permainan kegemaran anda.
Soalan Lazim
Adakah model tingkah laku musuh yang lebih maju menjadikan permainan video masa depan terlalu sukar untuk pemain kasual?
Tidak, pembangun melaksanakan sistem penskalaan kesukaran yang boleh disesuaikan yang melaraskan kependaman tindak balas, ketepatan dan keagresifan taktikal model terlatih.
Daripada hanya bergantung pada pengganda kerosakan mentah, slider kesukaran mengubah suai seberapa cepat rangkaian saraf menganalisis tindakan pemain dan melaksanakan strategi balas, memastikan pengalaman yang boleh diakses merentasi semua peringkat kemahiran.
Adakah pelaksanaan inferens neural masa nyata melumpuhkan kadar bingkai sistem pada konsol moden?
Platform perkakasan moden menggunakan blok pemprosesan saraf khusus untuk melaksanakan model inferens ringan dengan cekap di samping saluran paip pemaparan.
Dengan menggunakan rangkaian saraf yang dioptimumkan, enjin permainan memproses keputusan tingkah laku yang kompleks dalam bajet mikrosaat yang ketat, mengekalkan kadar bingkai yang lancar semasa senario pertempuran yang sengit.
Bagaimanakah pembangun permainan menghentikan musuh adaptif daripada menemui strategi pertempuran yang tiada tandingan?
Pereka bentuk memasang syarat sempadan yang ketat, had utiliti dan kelewatan tindak balas yang disengajakan dalam fungsi ganjaran untuk menyekat keupayaan ejen.
Kekangan yang disengajakan ini menghalang model daripada mengeksploitasi kelebihan mekanikal seperti penyasaran yang sempurna, kadar pusingan segera atau gelung penindasan tanpa henti, memastikan pertempuran kekal menarik dan adil.
Bolehkah sistem tingkah laku musuh adaptif berfungsi dalam permainan luar talian tanpa sambungan internet aktif?
Ya, pembangun melatih model rangkaian neural yang kompleks semasa penghasilan permainan pada pelayan awan berprestasi tinggi, kemudian memampatkan dasar terlatih akhir ke dalam fail runtime yang ringan.
Perkakasan tempatan membaca fail model pra-terlatih ini di luar talian, membolehkan tingkah laku penyesuaian yang canggih tanpa memerlukan sambungan pelayan aktif atau penstriman internet.
Bagaimanakah pembelajaran peneguhan berbeza daripada skrip pengaturcaraan permainan tradisional?
Pengaturcaraan permainan tradisional bergantung pada pembangun manusia yang menulis setiap pernyataan bersyarat, peraturan dan pokok keputusan secara manual untuk ejen musuh.
Pembelajaran pengukuhan menyediakan agen dengan matlamat, kekangan persekitaran dan sistem ganjaran, yang membolehkan sistem menemui manuver taktikal yang optimum melalui berjuta-juta lelaran permainan kendiri.
