
Bagaimana Pembelajaran Mesin Dapat Mengubah Perilaku Musuh dalam Game Masa Depan
Pengumuman
Pembelajaran mesin mengubah cara karakter non-pemain mengamati, beradaptasi, dan bereaksi terhadap strategi permainan modern di lingkungan digital yang kompleks.
Para pemain telah menghabiskan puluhan tahun mengeksploitasi pohon perilaku statis, rutinitas pencarian jalur yang dapat diprediksi, dan AI penjaga telepati yang mengatur ulang saat penghitung waktu berakhir.
Mesin game modern akhirnya mulai melampaui batasan skrip yang kaku untuk membangun ekosistem responsif yang belajar langsung dari keputusan pemain.
Desain musuh tradisional sangat bergantung pada mesin keadaan yang dikodekan secara manual, di mana pengembang memprogram setiap cabang keputusan, batasan, dan kondisi secara manual.
Ketika pemain menemukan celah dalam skrip statis tersebut, ilusi tantangan langsung hancur, membuat permainan terasa sepele.
Pengumuman
Algoritma dinamis memungkinkan pengembang untuk melatih jaringan saraf pada jutaan interaksi pemain, menciptakan lawan yang menyesuaikan taktik mereka secara real-time.
Apa yang Akan Anda Jelajahi dalam Artikel Ini
- Apa itu Machine Learning dalam Desain Game?
- Bagaimana Jaringan Saraf Tiruan Menggantikan Skrip Statis?
- Mengapa Naskah Musuh Tradisional Gagal Memenuhi Kebutuhan Pemain Modern?
- Bagaimana Pembelajaran Penguatan Melatih Lawan Virtual?
- Bagaimana Perilaku Dinamis Membentuk Kembali Sistem Pertempuran Dinamis?
- Mengapa Taktik Serangan Samping Adaptif Menggantikan Patroli Tetap?
- Bagaimana Pasukan NPC Dapat Mengkoordinasikan Taktik Tanpa Curang?
- Apa Peran Pencarian Jalur Prediktif dalam Game Siluman?
- Apa yang Menanti Intelijen Musuh Generasi Berikutnya?
- Mengapa Memori Prosedural Penting untuk Rival yang Berkelanjutan?
- Bagaimana Komputasi Awan Akan Memproses Model Perilaku Waktu Nyata?
- Apa Batasan Arsitektural dari Sistem AI yang Tidak Dapat Diprediksi?
- Analisis Perbandingan: Skrip Statis vs. AI Pembelajaran Mesin
- Awal Mula Musuh Digital yang Hidup
- Pertanyaan yang Sering Diajukan
Apa itu Machine Learning dalam Desain Game?
Bagaimana Jaringan Saraf Tiruan Menggantikan Skrip Statis?
Canggih pembelajaran mesin Kerangka kerja ini menggantikan perulangan "jika-maka" bersyarat dengan jaringan kebijakan fleksibel yang mengevaluasi vektor status permainan secara terus-menerus.
Alih-alih mengikuti alur kode kaku yang ditulis oleh perancang, sistem ini mengevaluasi jarak, garis pandang, cadangan kesehatan, dan pilihan senjata secara bersamaan untuk memilih strategi tandingan yang optimal.
Pergeseran mendasar ini mengubah target digital statis menjadi lawan yang fleksibel yang menganalisis pola pertempuran dan menyesuaikan posisi mereka secara dinamis selama pertempuran aktif.
Implementasi memerlukan pelatihan model pada kumpulan data yang luas tentang pergerakan pemain, pengelolaan sumber daya, dan penempatan taktis untuk menetapkan parameter perilaku dasar.
Para pengembang memasukkan skenario pertempuran simulasi ke dalam alur kerja pembelajaran mendalam, memungkinkan sistem untuk menyempurnakan responsnya melalui jutaan pertempuran berulang sebelum dirilis.
Agen runtime final menggunakan model inferensi ringan untuk memproses input pemain secara instan, mempertahankan frame rate yang lancar sambil membuat keputusan cerdas dan berdasarkan konteks.
Mengapa Naskah Musuh Tradisional Gagal Memenuhi Kebutuhan Pemain Modern?
Skrip musuh konvensional bergantung pada mesin keadaan terbatas deterministik yang akan runtuh di bawah tekanan strategi pemain yang kreatif dan tidak terduga.
Pemain berpengalaman dengan cepat menghafal rute patroli, area pandang, dan interval serangan, sehingga pertempuran berisiko tinggi berubah menjadi teka-teki spasial yang berulang.
Begitu seorang pemain menemukan titik buta yang tidak terduga atau celah dalam geometri pencarian jalur, tantangan buatan tersebut akan hilang sepenuhnya.
Musuh yang diprogram juga menderita akibat adanya pemisahan buatan antara pelacakan yang mahatahu dan kebutaan total, yang sering kali beralih antara kedua keadaan tersebut secara instan.
Mereka memiliki pengetahuan supranatural tentang koordinat pasti pemain melalui pembacaan geometri dinding atau berdiri acuh tak acuh sementara sekutu berjatuhan di dekatnya.
Model operasional biner ini merusak pengalaman bermain pemain, menyoroti keterbatasan mekanis dari arsitektur game tradisional.
++ Masa depan game dunia bersama di luar formula MMO.
Bagaimana Pembelajaran Penguatan Melatih Lawan Virtual?
Model pembelajaran penguatan (reinforcement learning) menggunakan fungsi penghargaan untuk memberi insentif kepada lawan virtual agar mencapai tujuan strategis seperti kontrol spasial, eksekusi serangan dari samping, dan bertahan hidup.
Agen digital menerima umpan balik matematis positif ketika berhasil memblokir jalur pelarian pemain atau menjaga kesehatan pasukan selama baku tembak.
Melalui jutaan iterasi permainan mandiri di dalam lingkungan simulasi, agen secara alami menemukan manuver taktis yang canggih tanpa instruksi eksplisit dari pengembang.
Sony AI mendemonstrasikan potensi transformatif ini dengan mengembangkan Sony AI Gran Turismo Sophy, sebuah agen yang dilatih melalui pembelajaran penguatan mendalam yang menguasai dinamika kendaraan yang kompleks, jalur balap, dan posisi bertahan untuk mengalahkan juara esports manusia papan atas.
Alih-alih menerima jalur mengemudi yang sudah ditentukan, Sophy mempelajari titik pengereman optimal dan taktik menyalip melalui uji coba dan kesalahan yang terus menerus.
Menerapkan arsitektur pelatihan serupa pada game aksi memungkinkan musuh untuk mempelajari mekanisme pertempuran yang kompleks dengan presisi layaknya manusia.
Bagaimana Perilaku Dinamis Membentuk Kembali Sistem Pertempuran Dinamis?
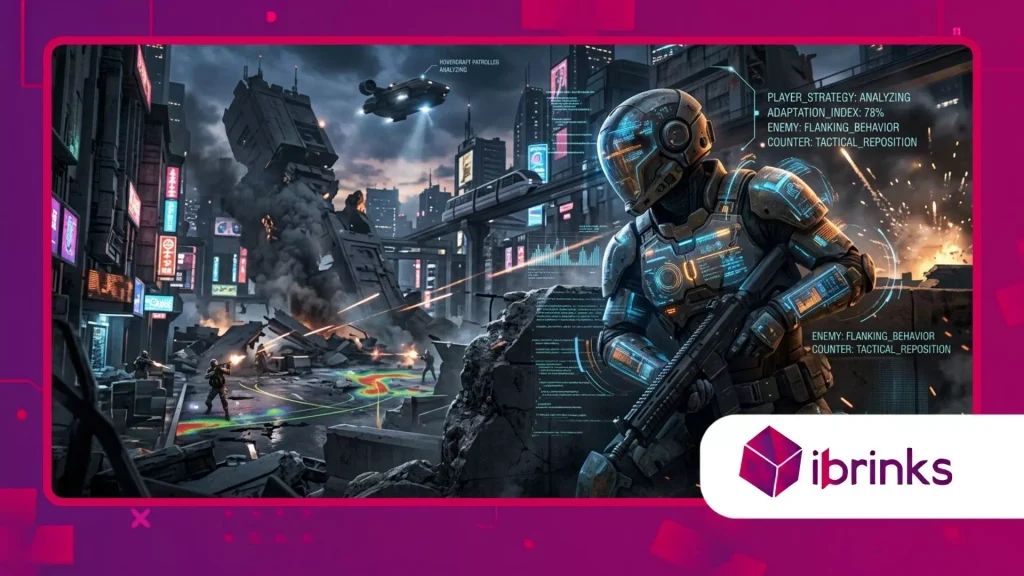
Mengapa Taktik Serangan Samping Adaptif Menggantikan Patroli Tetap?
Pertempuran modern membutuhkan lawan yang adaptif, yang menyesuaikan pergerakan spasial mereka berdasarkan posisi pemain, ketersediaan perlindungan, dan penekanan senjata.
Alih-alih bergerak mengikuti titik perlindungan yang telah ditentukan sebelumnya, musuh yang didukung oleh model dinamis mengevaluasi geometri medan secara real-time untuk menemukan sudut tembak yang menguntungkan.
Evolusi struktural ini memaksa pemain untuk meninggalkan strategi berkemah statis, karena lawan digital secara aktif bermanuver di sekitar tempat berlindung untuk menembus posisi pertahanan.
Agen adaptif menganalisis jangkauan senjata, siklus pengisian ulang, dan paparan garis pandang untuk mengeksekusi taktik tekanan multi-arah tanpa intervensi perancang.
Ketika seorang pemain memfokuskan tembakan ke satu arah, unit-unit di sisi sayap akan mengidentifikasi titik buta visual dan maju melalui jalur yang terlindungi.
Pergerakan yang dinamis ini menciptakan skenario pertempuran organik di mana garis pertempuran bergeser secara dinamis berdasarkan performa pemain, bukan berdasarkan pemicu yang telah diprogram.
Baca juga: Munculnya peta jalan berbasis komunitas yang menggantikan rencana pembangunan tetap.
Bagaimana Pasukan NPC Dapat Mengkoordinasikan Taktik Tanpa Curang?
Gim-gim lawas sering mensimulasikan kecerdasan kelompok dengan memberikan data telemetri bersama kepada anggota regu, memungkinkan mereka untuk melacak pemain melalui permukaan padat.
Modern pembelajaran mesin Model-model ini memungkinkan koordinasi regu yang autentik melalui protokol komunikasi lokal, meniru unit taktis dunia nyata yang berbagi data garis pandang yang sesuai dengan perspektif mereka.
Musuh hanya bereaksi terhadap informasi yang diverifikasi oleh sensor visual atau akustik mereka sendiri, menjaga permainan yang adil sambil menunjukkan strategi tim yang canggih.
Model regu terkoordinasi mendistribusikan peran taktis secara dinamis, menetapkan tembakan penekan, perlindungan mundur, dan manuver penge flanking berdasarkan kesehatan unit dan persenjataan.
Jika unit berat maju dengan perisai, penembak jitu pendukung secara otomatis berlindung di balik kendaraan lapis baja yang maju untuk menekan posisi pemain.
Koordinasi yang muncul ini terasa otentik karena setiap unit bertindak berdasarkan data lapangan yang dapat dipercaya, bukan berdasarkan kecurangan programatik yang murahan.
Baca selengkapnya: Bagaimana game modern menyeimbangkan kebebasan vs panduan tanpa memberikan bantuan berlebihan
Apa Peran Pencarian Jalur Prediktif dalam Game Siluman?
Gameplay stealth berubah secara dramatis ketika algoritma pencarian menggantikan siklus patroli linier dengan peta panas probabilistik yang berasal dari kebiasaan pemain.
Alih-alih berjalan di jalur tetap, model pencarian prediktif mengevaluasi pelanggaran garis pandang, pintu terbuka, dan jejak suara untuk memperkirakan di mana pemain yang menggunakan taktik siluman bersembunyi.
Musuh memusatkan upaya penyelidikan mereka pada tempat persembunyian yang memiliki kemungkinan tinggi, mengubah fase pencarian rutin menjadi penghindaran taktis yang menegangkan.
Algoritma pencarian jalur prediktif menghitung vektor pergerakan potensial berdasarkan berapa lama pemain berada di luar jangkauan kontak visual langsung.
Jika alarm berbunyi di area perimeter, petugas keamanan akan menghitung jarak maksimum yang dapat ditempuh pemain dalam jangka waktu tersebut dan membentuk perimeter pencarian sesuai dengan perhitungan tersebut.
Pernahkah Anda bertanya-tanya betapa menakutkannya pertemuan diam-diam ketika para penjaga secara aktif mengantisipasi rute pelarian Anda alih-alih mengikuti jejak remah roti?
Apa yang Menanti Intelijen Musuh Generasi Berikutnya?
Mengapa Memori Prosedural Penting untuk Rival yang Berkelanjutan?
Sistem rival yang berkelanjutan menggunakan arsitektur memori jangka panjang untuk menyimpan catatan gaya bermain pemain, senjata favorit, dan kecenderungan pertempuran di sepanjang kampanye yang panjang.
Ketika musuh berhasil selamat dari suatu pertempuran, model dasarnya memperbarui bobot keputusannya untuk melawan taktik spesifik yang sebelumnya mengalahkannya.
Jika seorang pemain sangat mengandalkan senapan sniper jarak jauh, lawan yang kembali akan muncul dengan granat asap, baju besi berat, dan taktik serangan jarak dekat.
Memori prosedural mengubah pertemuan musuh yang berulang dari pengecekan statistik yang monoton menjadi persaingan pribadi yang berkembang dan mencerminkan sejarah pemain.
Pihak lawan mengingat bekas luka fisik, kekalahan taktis, dan lolos dari bahaya, yang kemudian mengubah respons verbal dan perilaku tempur mereka selama konfrontasi berikutnya.
Kontinuitas historis ini memperdalam keterlibatan pemain dalam jangka panjang, karena setiap kemenangan taktis membentuk kembali lingkungan ancaman yang lebih luas.
Bagaimana Komputasi Awan Akan Memproses Model Perilaku Waktu Nyata?
Menjalankan model inferensi jaringan saraf yang kompleks bersamaan dengan rendering grafis kelas atas menghadirkan hambatan kinerja yang serius bagi perangkat keras konsol lokal.
Arsitektur berbasis cloud mengatasi kendala komputasi ini dengan menjalankan model perilaku intensif pada server jarak jauh dan mengirimkan keputusan taktis yang dioptimalkan kembali ke klien game.
Hal ini mengurangi beban komputasi aljabar linier yang berat dari prosesor lokal, memungkinkan pengembang untuk mengerahkan faksi musuh yang besar dan sangat cerdas tanpa mengorbankan kecepatan bingkai (frame rate).
Jaringan komputasi awan terdistribusi memungkinkan ribuan instance game aktif untuk terus menerus mengirimkan data keputusan pemain yang telah dianonimkan kembali ke model terpusat.
Saat jutaan pemain menguji celah keamanan baru secara global, jaringan terpusat memperbarui strategi balasan musuh secara real-time di seluruh basis pemain.
Siklus data berkelanjutan ini memastikan bahwa intelijen musuh berkembang seiring dengan strategi komunitas global, mencegah stagnasi meta-game.
Apa Batasan Arsitektural dari Sistem AI yang Tidak Dapat Diprediksi?
Mengintegrasikan model perilaku otonom ke dalam permainan naratif terstruktur menghadirkan tantangan desain permainan yang serius terkait kontrol, tempo, dan kepuasan pemain.
Jika model musuh mempelajari juga Secara efisien, ia menemukan siklus pertempuran yang tak terkalahkan, rutinitas penargetan yang sangat akurat, dan taktik penindasan instan yang membuat pemain frustrasi.
Perancang game harus membangun batasan perilaku yang ketat untuk membatasi efisiensi AI, memastikan lawan tetap menantang tanpa menjadi tidak adil atau tidak menyenangkan.
Para pengembang memanfaatkan kurva utilitas, penundaan reaksi yang disengaja, dan probabilitas kegagalan untuk menjaga agar model neural canggih tetap menyenangkan untuk digunakan.
Menyeimbangkan mesin pengambilan keputusan dinamis membutuhkan pengujian yang ketat untuk mencegah bug perilaku yang tidak terduga atau rutinitas pertempuran yang merusak permainan.
Menemukan keseimbangan yang tepat antara kecerdasan digital yang autentik dan umpan balik arcade yang memuaskan tetap menjadi tantangan utama bagi para arsitek game modern.
Analisis Perbandingan: Skrip Statis vs. AI Pembelajaran Mesin
Transisi struktural dari alur skrip deterministik ke model perilaku adaptif mengubah cara musuh digital bereaksi terhadap keputusan pemain.
Tabel di bawah ini merinci perbedaan operasional antara mesin keadaan terbatas lama dan jaringan kebijakan terlatih modern di seluruh dimensi inti permainan.
| Fitur Gameplay | Mesin Keadaan Terbatas Tradisional | Jaringan Perilaku Pembelajaran Mesin |
| Pencarian Jalur & Navigasi | Node titik arah tetap, garis kisi kaku | Evaluasi geometri spasial dinamis, penelusuran waktu nyata |
| Adaptasi Tempur | Kondisi pemicu yang telah ditentukan sebelumnya | Pembaruan kebijakan berkelanjutan berdasarkan taktik pemain secara langsung. |
| Koordinasi Pasukan | Data telemetri bersama (pembacaan dinding) | Relai sensor lokal, berbagi informasi yang autentik |
| Logika Pencarian Tersembunyi | Lingkaran patroli linier, kerucut penglihatan tetap | Peta panas probabilistik, pencarian spasial prediktif |
| Memori Jangka Panjang | Status akan diatur ulang setelah pemain mati/muncul kembali. | Berat badan tetap stabil di beberapa sesi bermain. |
| Alur Kerja Pengembangan | Pengkodean manual untuk setiap cabang keputusan | Pelatihan skenario otomatis melalui perulangan penguatan |
Awal Mula Musuh Digital yang Hidup
Integrasi pembelajaran mesin Masuknya perubahan mendasar ke dalam desain game modern menandai pergeseran dari target digital yang dapat diprediksi menuju lawan yang hidup dan bernapas.
Seiring dengan kematangan model pelatihan neural dan semakin lancarnya alur inferensi berbasis cloud, dunia game akan menampilkan ekosistem yang mengamati, beradaptasi, dan berevolusi seiring dengan strategi pemain.
Teknologi ini secara fundamental mengubah cara pemain mendekati tantangan taktis, mengubah kampanye statis menjadi pertempuran dinamis yang membutuhkan kecerdasan dan adaptasi.
Para pengembang game memiliki kekuatan untuk membangun dunia virtual yang menantang pemain tanpa harus menggunakan peningkatan statistik buatan atau kecurangan pemrograman yang murahan.
Pemain tidak lagi bisa mengalahkan tantangan tingkat tinggi dengan menghafal rute patroli atau memanfaatkan celah geometri yang rusak; kemenangan akan membutuhkan fleksibilitas taktis yang sesungguhnya dan pemecahan masalah yang kreatif.
Seiring berkembangnya sistem adaptif ini, bagikan pengalaman Anda di kolom komentar tentang bagaimana interaksi AI cerdas telah mengubah momen bermain game favorit Anda.
Pertanyaan yang Sering Diajukan
Akankah model perilaku musuh yang canggih membuat gim video di masa depan terlalu sulit bagi pemain kasual?
Tidak, pengembang menerapkan sistem penskalaan kesulitan yang dapat disesuaikan yang mengatur latensi respons, akurasi, dan agresivitas taktis dari model yang dilatih.
Alih-alih hanya mengandalkan pengali kerusakan mentah, penggeser kesulitan memodifikasi seberapa cepat jaringan saraf menganalisis tindakan pemain dan mengeksekusi strategi balasan, memastikan pengalaman yang mudah diakses di semua tingkat keahlian.
Apakah penerapan inferensi neural waktu nyata menurunkan kecepatan frame sistem pada konsol modern?
Platform perangkat keras modern menggunakan blok pemrosesan neural khusus untuk mengeksekusi model inferensi ringan secara efisien bersamaan dengan pipeline rendering.
Dengan memanfaatkan jaringan saraf yang dioptimalkan, mesin game memproses keputusan perilaku yang kompleks dalam anggaran mikrodetik yang ketat, menjaga kecepatan bingkai yang lancar selama skenario pertempuran yang intens.
Bagaimana para pengembang game mencegah musuh yang adaptif menemukan strategi tempur yang tak terkalahkan?
Para perancang memasang kondisi batas yang ketat, batasan utilitas, dan penundaan reaksi yang disengaja dalam fungsi imbalan untuk membatasi kemampuan agen.
Batasan yang disengaja ini mencegah model memanfaatkan keunggulan mekanis seperti bidikan sempurna, kecepatan putar instan, atau siklus penekanan tak terbatas, sehingga pertempuran tetap menarik dan adil.
Bisakah sistem perilaku musuh adaptif berfungsi dalam game offline tanpa koneksi internet aktif?
Ya, para pengembang melatih model jaringan saraf kompleks selama produksi game di server cloud berkinerja tinggi, kemudian mengompres kebijakan terlatih akhir ke dalam file runtime yang ringan.
Perangkat keras lokal membaca file model yang telah dilatih sebelumnya secara offline, memungkinkan perilaku adaptif yang canggih tanpa memerlukan koneksi server aktif atau streaming internet.
Bagaimana pembelajaran penguatan (reinforcement learning) berbeda dari skrip pemrograman game tradisional?
Pemrograman gim tradisional bergantung pada pengembang manusia yang secara manual menulis setiap pernyataan kondisional, aturan, dan pohon keputusan untuk agen musuh.
Pembelajaran penguatan (reinforcement learning) memberikan agen tujuan, batasan lingkungan, dan sistem penghargaan, yang memungkinkan sistem untuk menemukan manuver taktis optimal melalui jutaan iterasi permainan mandiri.
