
كيف يمكن للتعلم الآلي أن يغير سلوك الأعداء في الألعاب المستقبلية
إعلانات
التعلم الآلي يُحدث هذا تحولاً جذرياً في كيفية قيام الشخصيات غير القابلة للعب بملاحظة استراتيجيات الألعاب الحديثة والتكيف معها والتفاعل معها عبر بيئات رقمية معقدة.
لقد أمضى اللاعبون عقودًا في استغلال أشجار السلوك الثابتة، وروتينات البحث عن المسار المتوقعة، والذكاء الاصطناعي للحراس الذي يعمل عن بعد والذي يعيد ضبط نفسه في اللحظة التي ينتهي فيها المؤقت.
تتجه محركات الألعاب الحديثة أخيرًا إلى تجاوز قيود البرمجة النصية الجامدة لبناء أنظمة بيئية تفاعلية تتعلم مباشرة من قرارات اللاعبين.
يعتمد تصميم الأعداء التقليدي بشكل كبير على آلات الحالة المبرمجة مسبقًا حيث يقوم المطورون ببرمجة كل فرع قرار وحدود وشروط يدويًا.
عندما يكتشف اللاعبون ثغرة في تلك النصوص الثابتة، يتبدد وهم التحدي على الفور، مما يجعل اللعبة تبدو تافهة.
إعلانات
تسمح الخوارزميات الديناميكية للمطورين بتدريب الشبكات العصبية على ملايين التفاعلات بين اللاعبين، مما يؤدي إلى إنشاء خصوم يقومون بتعديل تكتيكاتهم في الوقت الفعلي.
ما ستتعرف عليه في هذه المقالة
- ما هو التعلم الآلي في تصميم الألعاب؟
- كيف تحل الشبكات العصبية محل النصوص الثابتة؟
- لماذا تفشل سيناريوهات الأعداء التقليدية مع اللاعبين المعاصرين؟
- كيف يقوم التعلم المعزز بتدريب الخصوم الافتراضيين؟
- كيف يُعيد السلوك الديناميكي تشكيل أنظمة القتال الديناميكية؟
- لماذا تحل تكتيكات المناورة التكيفية محل الدوريات الثابتة؟
- كيف يمكن لفرق الشخصيات غير القابلة للعب تنسيق التكتيكات دون غش؟
- ما هو دور البحث التنبؤي عن المسار في ألعاب التخفي؟
- ما الذي ينتظر الجيل القادم من أجهزة استخبارات العدو؟
- لماذا تعتبر الذاكرة الإجرائية ضرورية للمنافسين المستمرين؟
- كيف ستعالج الحوسبة السحابية نماذج السلوك في الوقت الفعلي؟
- ما هي الحدود المعمارية لأنظمة الذكاء الاصطناعي غير المتوقعة؟
- تحليل مقارن: البرامج النصية الثابتة مقابل الذكاء الاصطناعي القائم على التعلم الآلي
- فجر الخصوم الرقميين الأحياء
- الأسئلة الشائعة
ما هو التعلم الآلي في تصميم الألعاب؟
كيف تحل الشبكات العصبية محل النصوص الثابتة؟
متقدم التعلم الآلي تستبدل الأطر حلقات "إذا-ثم" الشرطية بشبكات سياسات مرنة تقوم بتقييم متجهات حالة اللعب المباشر بشكل مستمر.
بدلاً من اتباع سطور جامدة من التعليمات البرمجية التي كتبها المصممون، تقوم هذه الأنظمة بتقييم المسافة وخط الرؤية واحتياطيات الصحة وخيارات الأسلحة في وقت واحد لاختيار الاستراتيجيات المضادة المثلى.
هذا التحول الجذري يحول الأهداف الرقمية الثابتة إلى خصوم مرنين يقومون بتحليل أنماط القتال وتعديل مواقعهم بشكل ديناميكي أثناء المواجهات النشطة.
يتطلب التنفيذ تدريب النماذج على مجموعات بيانات ضخمة لحركة اللاعبين وإدارة الموارد والمواقع التكتيكية لتحديد معايير السلوك الأساسية.
يقوم المطورون بتغذية سيناريوهات القتال المحاكاة في مسارات التعلم العميق، مما يسمح للنظام بتحسين استجاباته عبر ملايين المعارك المتكررة قبل الإصدار.
يستخدم عامل وقت التشغيل النهائي نماذج استدلال خفيفة الوزن لمعالجة مدخلات اللاعب على الفور، مما يحافظ على معدلات إطارات سلسة مع اتخاذ قرارات ذكية ومدركة للسياق.
لماذا تفشل سيناريوهات الأعداء التقليدية مع اللاعبين المعاصرين؟
تعتمد سيناريوهات العدو التقليدية على آلات الحالة المحدودة الحتمية التي تنهار تحت وطأة استراتيجيات اللاعبين الإبداعية وغير المتوقعة.
يحفظ اللاعبون ذوو الخبرة بسرعة مسارات الدوريات، ومخاريط الرؤية، وفترات الهجوم، مما يقلل من مواجهات القتال عالية المخاطر إلى ألغاز مكانية متكررة.
بمجرد أن يكتشف اللاعب نقطة عمياء غير مخطط لها أو ثغرة في هندسة تحديد المسار، يختفي التحدي المصطنع تمامًا.
كما يعاني الأعداء المبرمجون من انقسام مصطنع بين التتبع الشامل والعمى التام، وغالبًا ما ينتقلون بين الحالتين على الفور.
إما أنهم يمتلكون معرفة خارقة للطبيعة بالإحداثيات الدقيقة للاعب من خلال قراءة هندسة الجدران، أو يقفون غافلين بينما يهبط الحلفاء في مكان قريب.
هذا النموذج التشغيلي الثنائي يكسر انغماس اللاعب، مما يسلط الضوء على القيود الميكانيكية لهندسة الألعاب التقليدية.
++ مستقبل ألعاب العالم المشترك خارج نطاق صيغة ألعاب تقمص الأدوار الجماعية عبر الإنترنت (MMO)
كيف يقوم التعلم المعزز بتدريب الخصوم الافتراضيين؟
تستخدم نماذج التعلم المعزز وظائف المكافأة لتحفيز الخصوم الافتراضيين نحو أهداف استراتيجية مثل السيطرة المكانية، وتنفيذ الهجمات الجانبية، والبقاء على قيد الحياة.
يحصل العملاء الرقميون على ردود فعل رياضية إيجابية عند نجاحهم في قطع طرق هروب اللاعبين أو الحفاظ على صحة الفرقة أثناء الاشتباكات النارية.
من خلال ملايين التكرارات للعب الذاتي داخل بيئات محاكاة، يكتشف العملاء بشكل طبيعي مناورات تكتيكية متطورة دون تعليمات صريحة من المطور.
أظهرت شركة سوني للذكاء الاصطناعي هذه الإمكانات التحويلية من خلال تطوير برنامج Gran Turismo Sophy من سوني للذكاء الاصطناعي، وهو برنامج تم تدريبه من خلال التعلم العميق المعزز الذي أتقن ديناميكيات المركبات المعقدة وخطوط السباق والمواقع الدفاعية لهزيمة أفضل أبطال الرياضات الإلكترونية البشرية.
بدلاً من تلقي مسارات قيادة محددة مسبقاً، تعلمت صوفي نقاط الكبح المثلى والتجاوز التكتيكي من خلال التجربة والخطأ المستمرين.
إن تطبيق بنى تدريب مماثلة على ألعاب الحركة يمكّن الأعداء من تعلم آليات القتال المعقدة بدقة تشبه دقة الإنسان.
كيف يُعيد السلوك الديناميكي تشكيل أنظمة القتال الديناميكية؟
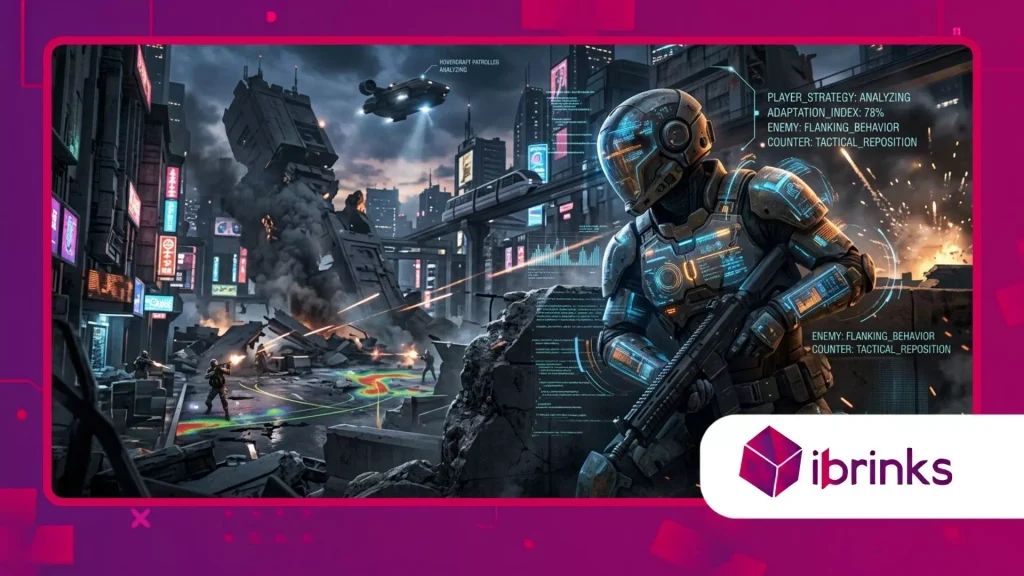
لماذا تحل تكتيكات المناورة التكيفية محل الدوريات الثابتة؟
تتطلب المواجهات القتالية الحديثة خصومًا متكيفين يقومون بتعديل حركتهم المكانية بناءً على موقع اللاعب، وتوافر الغطاء، وقمع الأسلحة.
بدلاً من الجري على طول نقاط التغطية المخبوزة مسبقًا، يقوم الأعداء المدعومون بنماذج ديناميكية بتقييم هندسة التضاريس في الوقت الفعلي لتحديد زوايا إطلاق النار المفيدة.
يجبر هذا التطور الهيكلي اللاعبين على التخلي عن استراتيجيات التخييم الثابتة، حيث يقوم الخصوم الرقميون بالمناورة بنشاط حول الغطاء لاختراق المواقع الدفاعية.
تقوم العوامل التكيفية بتحليل نطاقات الأسلحة، ودورات إعادة التحميل، ومستوى الرؤية لتنفيذ تكتيكات ضغط متعددة الجوانب دون تدخل المصمم.
عندما يركز اللاعب نيرانه في اتجاه واحد، تحدد الوحدات الجانبية نقطة العمى البصري وتتقدم على طول الممرات المكبوتة.
تخلق هذه الحركة السلسة سيناريوهات قتالية عضوية حيث تتغير خطوط المعركة ديناميكيًا بناءً على أداء اللاعب بدلاً من المحفزات المكتوبة مسبقًا.
اقرأ أيضاً: ظهور خرائط الطريق التي يقودها المجتمع لتحل محل خطط التنمية الثابتة
كيف يمكن لفرق الشخصيات غير القابلة للعب تنسيق التكتيكات دون غش؟
كثيراً ما كانت ألعاب الإرث تحاكي ذكاء المجموعة من خلال منح أعضاء الفريق بيانات قياس عن بعد مشتركة، مما يسمح لهم بتتبع اللاعبين عبر الأسطح الصلبة.
حديث التعلم الآلي تُمكّن النماذج من تنسيق الفرق بشكل أصيل من خلال بروتوكولات اتصال محلية، تحاكي الوحدات التكتيكية في العالم الحقيقي التي تتشارك بيانات خط الرؤية الخاصة بها.
لا يتفاعل الأعداء إلا مع المعلومات التي يتم التحقق منها بواسطة أجهزة الاستشعار البصرية أو الصوتية الخاصة بهم، مما يحافظ على اللعب النظيف مع إظهار استراتيجية فريق متطورة.
تقوم نماذج الفرق المنسقة بتوزيع الأدوار التكتيكية بشكل ديناميكي، حيث تقوم بتعيين نيران القمع، وتغطية الانسحاب، ومناورات الالتفاف بناءً على صحة الوحدة وأسلحتها.
إذا تقدمت وحدة ثقيلة مزودة بدرع، فإن جنود المشاة الداعمين يتخذون غطاءً تلقائياً خلف الدروع المتقدمة للضغط على موقع اللاعب.
يبدو هذا التنسيق الناشئ أصيلاً لأن كل وحدة تعمل بناءً على بيانات ميدانية موثوقة بدلاً من الغش البرمجي الرخيص.
اقرأ المزيد: كيف توازن الألعاب الحديثة بين الحرية والتوجيه دون مساعدة مباشرة؟
ما هو دور البحث التنبؤي عن المسار في ألعاب التخفي؟
تتغير طريقة اللعب بالتخفي بشكل كبير عندما تستبدل خوارزميات البحث حلقات الدوريات الخطية بخرائط حرارية احتمالية مستمدة من عادات اللاعبين.
بدلاً من السير في مسارات ثابتة، تقوم نماذج البحث التنبؤية بتقييم اختراقات خط الرؤية والأبواب المفتوحة وآثار الضوضاء لتقدير أماكن اختباء اللاعبين المتخفين.
يركز الأعداء جهودهم الاستقصائية على أماكن الاختباء ذات الاحتمالية العالية، مما يحول مراحل البحث الروتينية إلى عمليات مراوغة تكتيكية متوترة.
تقوم خوارزميات البحث عن المسار التنبؤي بحساب متجهات الحركة المحتملة بناءً على المدة التي انقطع فيها اللاعب عن الاتصال البصري المباشر.
إذا انطلق جهاز الإنذار على المحيط، يقوم الحراس بحساب أقصى مسافة يمكن أن يقطعها اللاعب خلال تلك الفترة الزمنية ويشكلون محيطات البحث وفقًا لذلك.
هل تساءلت يوماً عن مدى رعب المواجهات الخفية عندما يتوقع الحراس مسار هروبك بنشاط بدلاً من اتباع آثار الفتات؟
ما الذي ينتظر الجيل القادم من أجهزة استخبارات العدو؟
لماذا تعتبر الذاكرة الإجرائية ضرورية للمنافسين المستمرين؟
تستخدم أنظمة المنافسة المستمرة بنى ذاكرة طويلة المدى للاحتفاظ بسجلات أساليب لعب اللاعبين وأسلحتهم المفضلة وميولهم القتالية عبر الحملات الممتدة.
عندما ينجو العدو من المواجهة، يقوم نموذجه الأساسي بتحديث أوزان قراراته لمواجهة التكتيكات المحددة التي هزمته سابقًا.
إذا اعتمد اللاعب بشكل كبير على بنادق القنص بعيدة المدى، فإن المنافسين العائدين سيظهرون مزودين بقنابل دخانية ودروع ثقيلة وتكتيكات هجومية قريبة المدى.
تعمل الذاكرة الإجرائية على تحويل مواجهات الأعداء المتكررة من مجرد عمليات فحص إحصائية متكررة إلى منافسات شخصية متطورة تعكس تاريخ اللاعب.
يتذكر الخصوم الندوب الجسدية والهزائم التكتيكية والنجاة بأعجوبة، مما يؤدي إلى تغيير ردود أفعالهم اللفظية وسلوكهم القتالي خلال المواجهات اللاحقة.
هذا الاستمرار التاريخي يعمق مشاركة اللاعبين على المدى الطويل، حيث أن كل انتصار تكتيكي يعيد تشكيل بيئة التهديد الأوسع.
كيف ستعالج الحوسبة السحابية نماذج السلوك في الوقت الفعلي؟
إن تنفيذ نماذج استدلال الشبكات العصبية المعقدة جنبًا إلى جنب مع عرض الرسومات المتطورة يمثل اختناقات أداء شديدة لأجهزة وحدة التحكم المحلية.
تعمل البنية المدعومة بالسحابة على حل هذا القيد الحسابي من خلال تشغيل نماذج سلوكية مكثفة على خوادم بعيدة وبث القرارات التكتيكية المحسّنة مرة أخرى إلى عميل اللعبة.
يؤدي هذا إلى تخفيف عبء حسابات الجبر الخطي الثقيلة عن المعالجات المحلية، مما يسمح للمطورين بنشر فصائل عدو ضخمة وذات ذكاء عالٍ دون المساس بمعدلات الإطارات.
تتيح شبكات الحوسبة السحابية الموزعة لآلاف من مثيلات الألعاب النشطة تغذية بيانات قرارات اللاعبين المجهولة الهوية إلى نموذج مركزي بشكل مستمر.
بينما يقوم ملايين اللاعبين باختبار ثغرات جديدة على مستوى العالم، تقوم الشبكة المركزية بتحديث استراتيجيات العدو المضادة في الوقت الفعلي عبر قاعدة اللاعبين بأكملها.
تضمن حلقة البيانات المستمرة هذه تطور معلومات العدو جنبًا إلى جنب مع استراتيجيات المجتمع العالمي، مما يمنع ركود اللعبة.
ما هي الحدود المعمارية لأنظمة الذكاء الاصطناعي غير المتوقعة؟
إن دمج نماذج السلوك المستقلة في ألعاب السرد المنظمة يطرح تحديات جدية في تصميم الألعاب فيما يتعلق بالتحكم، والوتيرة، ورضا اللاعب.
إذا تعلم نموذج العدو أيضاً بكفاءة، يكتشف حلقات قتالية لا تُقهر، وروتينات استهداف دقيقة للغاية، وتكتيكات قمع فورية تُسبب إحباط اللاعبين.
يجب على مصممي الألعاب وضع ضوابط سلوكية صارمة للحد من كفاءة الذكاء الاصطناعي، مما يضمن بقاء الخصوم يمثلون تحديًا دون أن يصبحوا غير عادلين أو غير ممتعين.
يستخدم المطورون منحنيات المنفعة، وتأخيرات رد الفعل المتعمدة، واحتمالات الفشل لجعل النماذج العصبية المتقدمة ممتعة للتفاعل معها.
يتطلب تحقيق التوازن في محركات اتخاذ القرارات الديناميكية إجراء اختبارات صارمة لمنع حدوث أخطاء سلوكية غير متوقعة أو إجراءات قتالية مدمرة للعبة.
لا يزال تحقيق التوازن الدقيق بين الذكاء الرقمي الأصيل وردود الفعل المرضية في ألعاب الأركيد يمثل التحدي الرئيسي لمهندسي تصميم الألعاب الحديثة.
تحليل مقارن: البرامج النصية الثابتة مقابل الذكاء الاصطناعي القائم على التعلم الآلي
إن التحول الهيكلي من مسارات البرمجة النصية الحتمية إلى نماذج السلوك التكيفية يغير طريقة تفاعل الخصوم الرقميين مع قرارات اللاعبين.
يوضح الجدول أدناه الاختلافات التشغيلية بين آلات الحالة المحدودة القديمة وشبكات السياسات المدربة الحديثة عبر أبعاد اللعب الأساسية.
| ميزة اللعب | آلات الحالة المحدودة التقليدية | شبكات التعلم الآلي السلوكية |
| تحديد المسار والتنقل | نقاط مسار ثابتة، خطوط شبكة صلبة | تقييم الهندسة المكانية الديناميكية، والتنقل في الوقت الحقيقي |
| التكيف القتالي | شروط التشغيل المحددة مسبقًا | تحديثات مستمرة للسياسات بناءً على تكتيكات اللاعبين المباشرة |
| تنسيق الفريق | بيانات القياس عن بعد المشتركة (قراءة الجدار) | ترحيل المستشعرات الموضعية، ومشاركة المعلومات الموثوقة |
| منطق البحث الخفي | حلقات دورية خطية، مخاريط رؤية ثابتة | الخرائط الحرارية الاحتمالية، البحث المكاني التنبؤي |
| الذاكرة طويلة المدى | إعادة ضبط الحالة عند موت اللاعب/عودته إلى الحياة | احتفاظ مستمر بالوزن خلال جلسات لعب متعددة |
| سير عمل التطوير | الترميز اليدوي لكل فرع من فروع القرار | التدريب الآلي على السيناريوهات عبر حلقات التعزيز |
فجر الخصوم الرقميين الأحياء
تكامل التعلم الآلي يمثل الانتقال إلى تصميم الألعاب الحديثة تحولاً جذرياً من الأهداف الرقمية المتوقعة إلى الخصوم الأحياء والمتفاعلين.
مع نضوج نماذج التدريب العصبي وتطور خطوط استدلال السحابة لتصبح سلسة، ستضم عوالم الألعاب أنظمة بيئية تراقب وتتكيف وتتطور جنبًا إلى جنب مع استراتيجيات اللاعبين.
تُغير هذه التقنية بشكل جذري الطريقة التي يتعامل بها اللاعبون مع التحديات التكتيكية، محولةً الحملات الثابتة إلى معارك ديناميكية تعتمد على الاستخبارات والتكيف.
يمتلك مطورو الألعاب القدرة على بناء عوالم افتراضية تتحدى اللاعبين دون اللجوء إلى تعزيزات إحصائية مصطنعة أو اختراقات برمجية رخيصة.
لن يتمكن اللاعبون بعد الآن من التغلب على المواجهات عالية المستوى عن طريق حفظ مسارات الدوريات أو استغلال نقاط الهندسة المعيبة؛ سيتطلب النصر مرونة تكتيكية حقيقية وحلًا إبداعيًا للمشاكل.
مع تطور هذه الأنظمة التكيفية، شاركنا تجاربك في التعليقات حول كيف أثرت مواجهات الذكاء الاصطناعي الذكية على لحظاتك المفضلة في الألعاب.
الأسئلة الشائعة
هل ستجعل نماذج سلوك الأعداء المتقدمة ألعاب الفيديو المستقبلية صعبة للغاية بالنسبة للاعبين العاديين؟
لا، يقوم المطورون بتطبيق أنظمة قابلة للتخصيص لتعديل صعوبة النماذج المدربة، والتي تعمل على ضبط زمن الاستجابة والدقة والفعالية التكتيكية.
بدلاً من الاعتماد فقط على مضاعفات الضرر الخام، تعمل أشرطة التمرير الخاصة بالصعوبة على تعديل سرعة تحليل الشبكات العصبية لأفعال اللاعب وتنفيذ الاستراتيجيات المضادة، مما يضمن تجارب يمكن الوصول إليها عبر جميع مستويات المهارة.
هل يؤدي تطبيق الاستدلال العصبي في الوقت الحقيقي إلى إضعاف معدلات الإطارات في النظام على أجهزة الألعاب الحديثة؟
تستخدم منصات الأجهزة الحديثة وحدات معالجة عصبية مخصصة لتنفيذ نماذج الاستدلال الخفيفة بكفاءة إلى جانب خطوط أنابيب العرض.
من خلال استخدام الشبكات العصبية المحسّنة، تعالج محركات الألعاب القرارات السلوكية المعقدة ضمن ميزانيات زمنية ضيقة تصل إلى أجزاء من الثانية، مما يحافظ على معدلات الإطارات السلسة أثناء سيناريوهات القتال الشديدة.
كيف يمنع مطورو الألعاب الأعداء المتكيفين من اكتشاف استراتيجيات قتالية لا تُقهر؟
يقوم المصممون بوضع شروط حدودية صارمة، وحدود قصوى للمنفعة، وتأخيرات متعمدة في رد الفعل ضمن وظيفة المكافأة لتقييد قدرات الوكيل.
تمنع هذه القيود المتعمدة النماذج من استغلال المزايا الميكانيكية مثل التصويب المثالي، ومعدلات الدوران الفورية، أو حلقات القمع اللانهائية، مما يحافظ على مواجهات القتال مثيرة وعادلة.
هل يمكن لأنظمة سلوك العدو التكيفية أن تعمل في الألعاب غير المتصلة بالإنترنت بدون اتصال نشط بالإنترنت؟
نعم، يقوم المطورون بتدريب نماذج الشبكات العصبية المعقدة أثناء إنتاج الألعاب على خوادم سحابية عالية الأداء، ثم يقومون بضغط السياسة المدربة النهائية في ملف تشغيل خفيف الوزن.
تقوم الأجهزة المحلية بقراءة ملف النموذج المدرب مسبقًا هذا دون اتصال بالإنترنت، مما يتيح سلوكًا تكيفيًا متطورًا دون الحاجة إلى اتصالات خادم نشطة أو بث عبر الإنترنت.
كيف يختلف التعلم المعزز عن نصوص برمجة الألعاب التقليدية؟
تعتمد برمجة الألعاب التقليدية على قيام المطورين البشريين بكتابة كل عبارة شرطية وقاعدة وشجرة قرار لعميل العدو يدويًا.
يوفر التعلم المعزز للوكيل أهدافًا وقيودًا بيئية ونظام مكافآت، مما يسمح للنظام باكتشاف المناورات التكتيكية المثلى من خلال ملايين التكرارات الذاتية.
